FastAPI 서비스 골격, RabbitMQ DLQ, Harbor+Trivy, Jenkins→ArgoCD 파이프라인 구축 절차
메시지 큐·CI/CD 개념부터, 헬스체크/메트릭을 표준화한 api-server·inference-worker 골격, RabbitMQ ack/nack+DLQ, Harbor 사설 레지스트리+Trivy 스캔, Jenkins 빌드와 ArgoCD GitOps 배포, 선택 확장인 CloudNativePG까지.
목표
api-server(FastAPI)와 inference-worker(비동기 워커) 두 서비스를 최소 골격으로 만들고, 둘 사이를 RabbitMQ로 연결한다. 그 다음 Jenkins로 빌드하고, Harbor 사설 레지스트리에 Trivy로 스캔한 이미지를 올리고, ArgoCD로 배포하는 파이프라인까지 연결한다. (선택 확장으로 PostgreSQL을 CloudNativePG 오퍼레이터로 운영하는 것도 다룬다.)
실제 구축 절차
1. api-server 골격 - 헬스체크/메트릭 표준화
Kubernetes는 파드가 "살아있는지"와 "트래픽을 받을 준비가 됐는지"를 각각 다른 방식으로 확인한다 - 프로세스가 떠 있어도 DB 연결이 안 되어 있으면 트래픽을 받으면 안 되기 때문이다. 이 확인 방식을 서비스마다 다르게 만들면 게이트웨이 라우팅과 모니터링 양쪽에 태울 수 없으니, 엔드포인트 형식을 먼저 고정한다.
# api-server/app/main.py
from fastapi import FastAPI
from prometheus_fastapi_instrumentator import Instrumentator

app = FastAPI()
Instrumentator().instrument(app).expose(app, endpoint="/metrics")

@app.get("/healthz")
def healthz():
    return {"status": "ok"}

@app.post("/jobs")
def create_job(payload: JobCreate):
    job_id = save_job_as_pending(payload)
    publish_to_queue("jobs.upload", {"job_id": job_id, **payload.dict()})
    return {"job_id": job_id, "status": "PENDING"}

@app.get("/jobs/{job_id}")
def get_job(job_id: str):
    return get_job_status(job_id)
/healthz는 프로세스 생존만 확인하고, DB·큐 연결까지 확인하는 /readyz를 별도로 두는 편이 낫다 - /healthz가 무거우면 kubelet의 liveness probe가 불필요하게 서비스를 재시작시킬 수 있다.
@app.get("/readyz")
def readyz():
    if not rabbitmq_connection.is_open:
        raise HTTPException(status_code=503, detail="rabbitmq not connected")
    return {"status": "ready"}
이걸 "귀찮으니 생략" 하면 실제로 생기는 실패 시나리오가 있다. RabbitMQ 파드가 롤링 재시작되는 동안 api-server의 readiness가 여전히 200을 반환하면, Service는 이 파드가 정상이라고 믿고 계속 트래픽을 라우팅한다 - 사용자는 /jobs 호출이 500으로 튕기는 걸 그대로 겪는다. readiness가 RabbitMQ 연결 상태까지 반영하면 그 순간 해당 파드가 Endpoints에서 빠지고, 살아있는 다른 파드로만 요청이 몰린다 - 사용자 입장에선 에러가 아니라 약간의 지연으로만 보인다. 반대로 이 DB·큐 체크를 /healthz(liveness) 쪽에 넣으면 더 위험하다 - RabbitMQ가 잠깐 다운된 것뿐인데 kubelet이 "죽었다"고 판단해 모든 api-server 파드를 동시에 재시작시키는 사태가 벌어질 수 있다. liveness는 "이 프로세스를 재시작해야 하는가"를, readiness는 "지금 이 파드로 트래픽을 보내도 되는가"를 답하는 서로 다른 질문이라는 걸 엔드포인트를 나누면서 체감하게 된다.
2. RabbitMQ 배포 - StatefulSet + ack/nack + DLQ
메시지 큐란 무엇이고 왜 쓰는가: api-server가 이미지 업로드 요청을 받자마자 AI 추론까지 끝내고 응답하면 사용자는 몇 분을 기다려야 한다. 대신 "작업 접수"만 즉시 응답하고, 실제 처리는 별도 워커가 나중에 하도록 미루는 게 비동기 처리다. 이때 api-server와 inference-worker가 서로를 직접 호출하면, 워커가 잠깐이라도 다운된 순간의 요청은 그냥 사라진다. 메시지 큐는 그 사이에서 "작업이 접수됐다"는 사실 자체를 저장해두는 중간 저장소다 - 워커가 나중에 다시 살아나도 큐에 쌓인 작업을 그대로 이어받을 수 있다.
helm repo add bitnami https://charts.bitnami.com/bitnami
helm install rabbitmq bitnami/rabbitmq \
  --set auth.username=app \
  --set auth.password=<시크릿으로 관리> \
  --set replicaCount=1
ack/nack이란: 큐는 메시지를 워커에게 전달한 것만으로 "처리 완료"라고 여기지 않는다. 워커가 실제로 작업을 끝낸 뒤 명시적으로 "ack(확인)"을 보내야 큐에서 그 메시지가 지워진다. 워커가 처리 도중 죽어서 ack를 못 보내면, 큐는 그 메시지를 다른 워커에게 다시 전달한다 - 이게 "작업이 사라지지 않는다"는 보장의 실체다. nack은 "실패했다"는 명시적 신호이고, 반복 실패한 메시지를 **DLQ(Dead Letter Queue)**라는 별도 큐로 격리해 무한 재시도를 막는다.
# inference-worker/app/queue_setup.py
import pika

def declare_queues(channel):
    channel.exchange_declare("jobs.dlx", exchange_type="direct")
    channel.queue_declare("jobs.dlq", durable=True)
    channel.queue_bind("jobs.dlq", "jobs.dlx", routing_key="jobs.upload")

    channel.queue_declare(
        "jobs.upload",
        durable=True,
        arguments={
            "x-dead-letter-exchange": "jobs.dlx",
            "x-dead-letter-routing-key": "jobs.upload",
        },
    )
nack(requeue=True)만으로 재시도를 구현하면 문제가 하나 생긴다 - 메시지가 큐 맨 뒤로 갔다가 바로 다시 워커에게 전달되기 때문에, 실패 원인이 "다운스트림이 잠깐 응답 안 함" 같은 일시적 장애일 때는 즉시 재시도가 오히려 그 다운스트림에 부하를 더 얹는다. RabbitMQ 자체에는 "N초 뒤에 재시도"라는 지연 재시도 기능이 없어서, TTL이 걸린 큐를 계단식으로 만들어 우회한다 - 메시지가 jobs.retry.1(TTL 5초)에 들어가 있다가 TTL이 만료되면 dead-letter로 원래 큐(jobs.upload)에 돌아오고, 그래도 또 실패하면 jobs.retry.2(TTL 30초), 그다음 jobs.retry.3(TTL 2분)로 넘어간다. 실패할 때마다 대기 시간이 늘어나는 지수 백오프를 큐 설정만으로 구현하는 방법이다.
# inference-worker/app/queue_setup.py (재시도 큐 계단 추가)
RETRY_LADDER_MS = [5_000, 30_000, 120_000]  # 5s → 30s → 2m

def declare_retry_queues(channel):
    for i, ttl_ms in enumerate(RETRY_LADDER_MS, start=1):
        channel.queue_declare(
            f"jobs.retry.{i}",
            durable=True,
            arguments={
                "x-message-ttl": ttl_ms,
                "x-dead-letter-exchange": "",                 # 기본 익스체인지
                "x-dead-letter-routing-key": "jobs.upload",    # TTL 만료 후 원래 큐로 복귀
            },
        )
# inference-worker/app/consumer.py
def on_message(channel, method, properties, body):
    headers = properties.headers or {}
    death_count = _retry_count(headers)  # x-death 배열 길이로 계산
    job_id = headers.get("job_id")
    try:
        run_inference(body, idempotency_key=job_id)
        channel.basic_ack(delivery_tag=method.delivery_tag)
    except TransientError:
        # 일시적 장애(타임아웃, 커넥션 끊김 등) - 백오프 후 재시도
        if death_count >= len(RETRY_LADDER_MS):
            channel.basic_nack(delivery_tag=method.delivery_tag, requeue=False)  # DLQ로 최종 격리
        else:
            channel.basic_publish(
                exchange="", routing_key=f"jobs.retry.{death_count + 1}",
                body=body, properties=properties,
            )
            channel.basic_ack(delivery_tag=method.delivery_tag)  # 원본은 ack, 재시도 큐가 이어받음
    except PermanentError:
        # 입력 자체가 잘못됨(깨진 이미지, 파싱 불가 등) - 재시도해도 결과가 바뀌지 않으므로 즉시 DLQ
        channel.basic_nack(delivery_tag=method.delivery_tag, requeue=False)
TransientError와 PermanentError를 구분하는 게 핵심이다 - death_count만 보고 "3번 실패하면 DLQ"로 처리하면, 애초에 재시도해도 절대 성공할 수 없는 메시지(예: 손상된 이미지 파일)까지 재시도 큐를 세 바퀴 돌며 최대 2분 넘게 자원을 낭비하게 된다. 원인을 구분할 수 있다면 poison message는 첫 실패에서 곧바로 DLQ로 보내는 게 맞다.
inference-worker는 처음엔 실제 ONNX 모델 대신 time.sleep(180)으로 "오래 걸리는 작업"만 흉내 낸다 - 파이프라인 자체(큐 소비, ack/nack, 상태 갱신)가 먼저 제대로 도는지 검증하는 게 우선이다.
DLQ 재처리 전략 - 격리 후 처리와 중복 실행 방지
DLQ는 "버리는 곳"이 아니라 "사람이 확인할 대기실"이다. 메시지가 DLQ에 들어갔다는 건 재시도 큐 계단을 다 거치고도(혹은 poison message라서 곧바로) 실패했다는 뜻이고, 이걸 그냥 방치하면 사용자는 자기 작업이 왜 끝나지 않는지 영원히 알 수 없다. 실무에서는 보통 세 갈래로 처리한다.
- 일시적 장애였던 것으로 판단되면 - 원인(다운스트림 장애, 리소스 부족 등)을 고친 뒤 DLQ 컨슈머나 운영자가 수동으로
jobs.upload에 재투입한다. 자동 재투입은 하지 않는다 - 원인을 안 고치고 재투입하면 다시 DLQ로 돌아올 뿐이다. - 입력 자체가 잘못된 것으로 판단되면 - job 상태를
FAILED로 갱신해 사용자에게 알리고, 메시지는 DLQ에서 제거한다. 재시도할 이유가 없다. - 원인이 바로 안 보이면 - 메시지 본문을 S3 등 별도 저장소에 덤프해두고 DLQ에서는 빼서, 나중에 배치로 분석한다. DLQ에 메시지가 무한정 쌓이게 두면 다음 장애 때 진짜 원인 파악이 더 어려워진다.
이 처리가 사람 손을 거치므로, RabbitMQ Management API로 jobs.dlq의 메시지 개수에 알람을 걸어둔다 - DLQ에 뭔가 쌓이기 시작했다는 사실 자체가 모니터링 대상이다.
멱등성(idempotency) 보장: 재시도 구조를 넣는 순간 반드시 따라오는 문제가 있다 - 워커가 run_inference는 끝냈는데 결과를 DB에 쓰기 전에 죽으면 ack를 못 보내고, 메시지는 재전달된다. 즉 같은 작업이 두 번 실행될 수 있다는 뜻이다. 추론 자체는 두 번 돌아도 크게 문제 없어 보일 수 있지만, "완료 알림을 두 번 보낸다"거나 "결과를 집계 테이블에 두 번 더한다"처럼 부수효과가 있는 작업이면 데이터가 틀어진다. 그래서 job_id를 멱등키로 써서 재실행 자체를 막는다.
def run_inference(body, idempotency_key):
    existing = get_job_result(idempotency_key)
    if existing and existing["status"] == "DONE":
        return existing  # 이미 처리된 job_id - 재실행하지 않고 기존 결과 반환
    result = model.predict(body["image_url"])
    save_job_result(idempotency_key, result, status="DONE")  # job_id에 UNIQUE 제약
    return result
job_id 컬럼에 DB 레벨 UNIQUE 제약을 걸어두면, 두 워커가 (아주 드물게) 같은 메시지를 동시에 받아 처리하더라도 INSERT ... ON CONFLICT DO NOTHING 패턴으로 결과가 중복 저장되는 걸 애플리케이션 로직이 아니라 DB가 막아준다 - "메시지가 최소 한 번은 처리된다(at-least-once)"는 큐의 보장과 "몇 번 처리되든 결과는 한 번만 반영된다"는 멱등성을 합쳐야 실제로 안전한 재시도가 된다.
3. 검증 실험 설계 - 워커 강제 종료
# 작업 하나를 등록한 뒤, 처리 중인 워커 파드를 강제 종료
kubectl delete pod <inference-worker-pod> --grace-period=0 --force

# 확인할 것
# 1) 메시지가 ack 안 된 상태로 큐에 남아있다가 재전달되는지 (RabbitMQ Management UI의 Unacked 카운트)
# 2) 재시작된 워커(또는 다른 레플리카)가 같은 메시지를 다시 처리하는지
# 3) 의도적으로 3회 실패하는 메시지를 만들어 DLQ로 격리되는지 (jobs.dlq 큐 확인)
4. Harbor 사설 레지스트리 + Trivy 스캔
컨테이너 레지스트리란: docker build로 만든 이미지는 그 자체로는 클러스터의 다른 노드에서 쓸 수 없다 - 이미지를 어딘가에 올려두고, 각 노드가 그곳에서 내려받도록 해야 한다. Docker Hub 같은 공개 레지스트리를 그대로 써도 되지만, 사내 코드가 담긴 이미지를 외부에 공개하고 싶지 않다면 직접 운영하는 사설 레지스트리가 필요하다. Harbor는 그 사설 레지스트리 구현체이고, 이미지를 푸시할 때 자동으로 취약점을 스캔하는 Trivy가 내장되어 있다.
helm repo add harbor https://helm.goharbor.io
helm install harbor harbor/harbor \
  --set expose.type=ingress \
  --set expose.ingress.hosts.core=harbor.local \
  --set externalURL=https://harbor.local \
  --set trivy.enabled=true
Harbor 프로젝트(네임스페이스 개념)를 하나 만들고, 그 프로젝트에 "취약점이 발견되면 배포 차단" 정책을 건다.
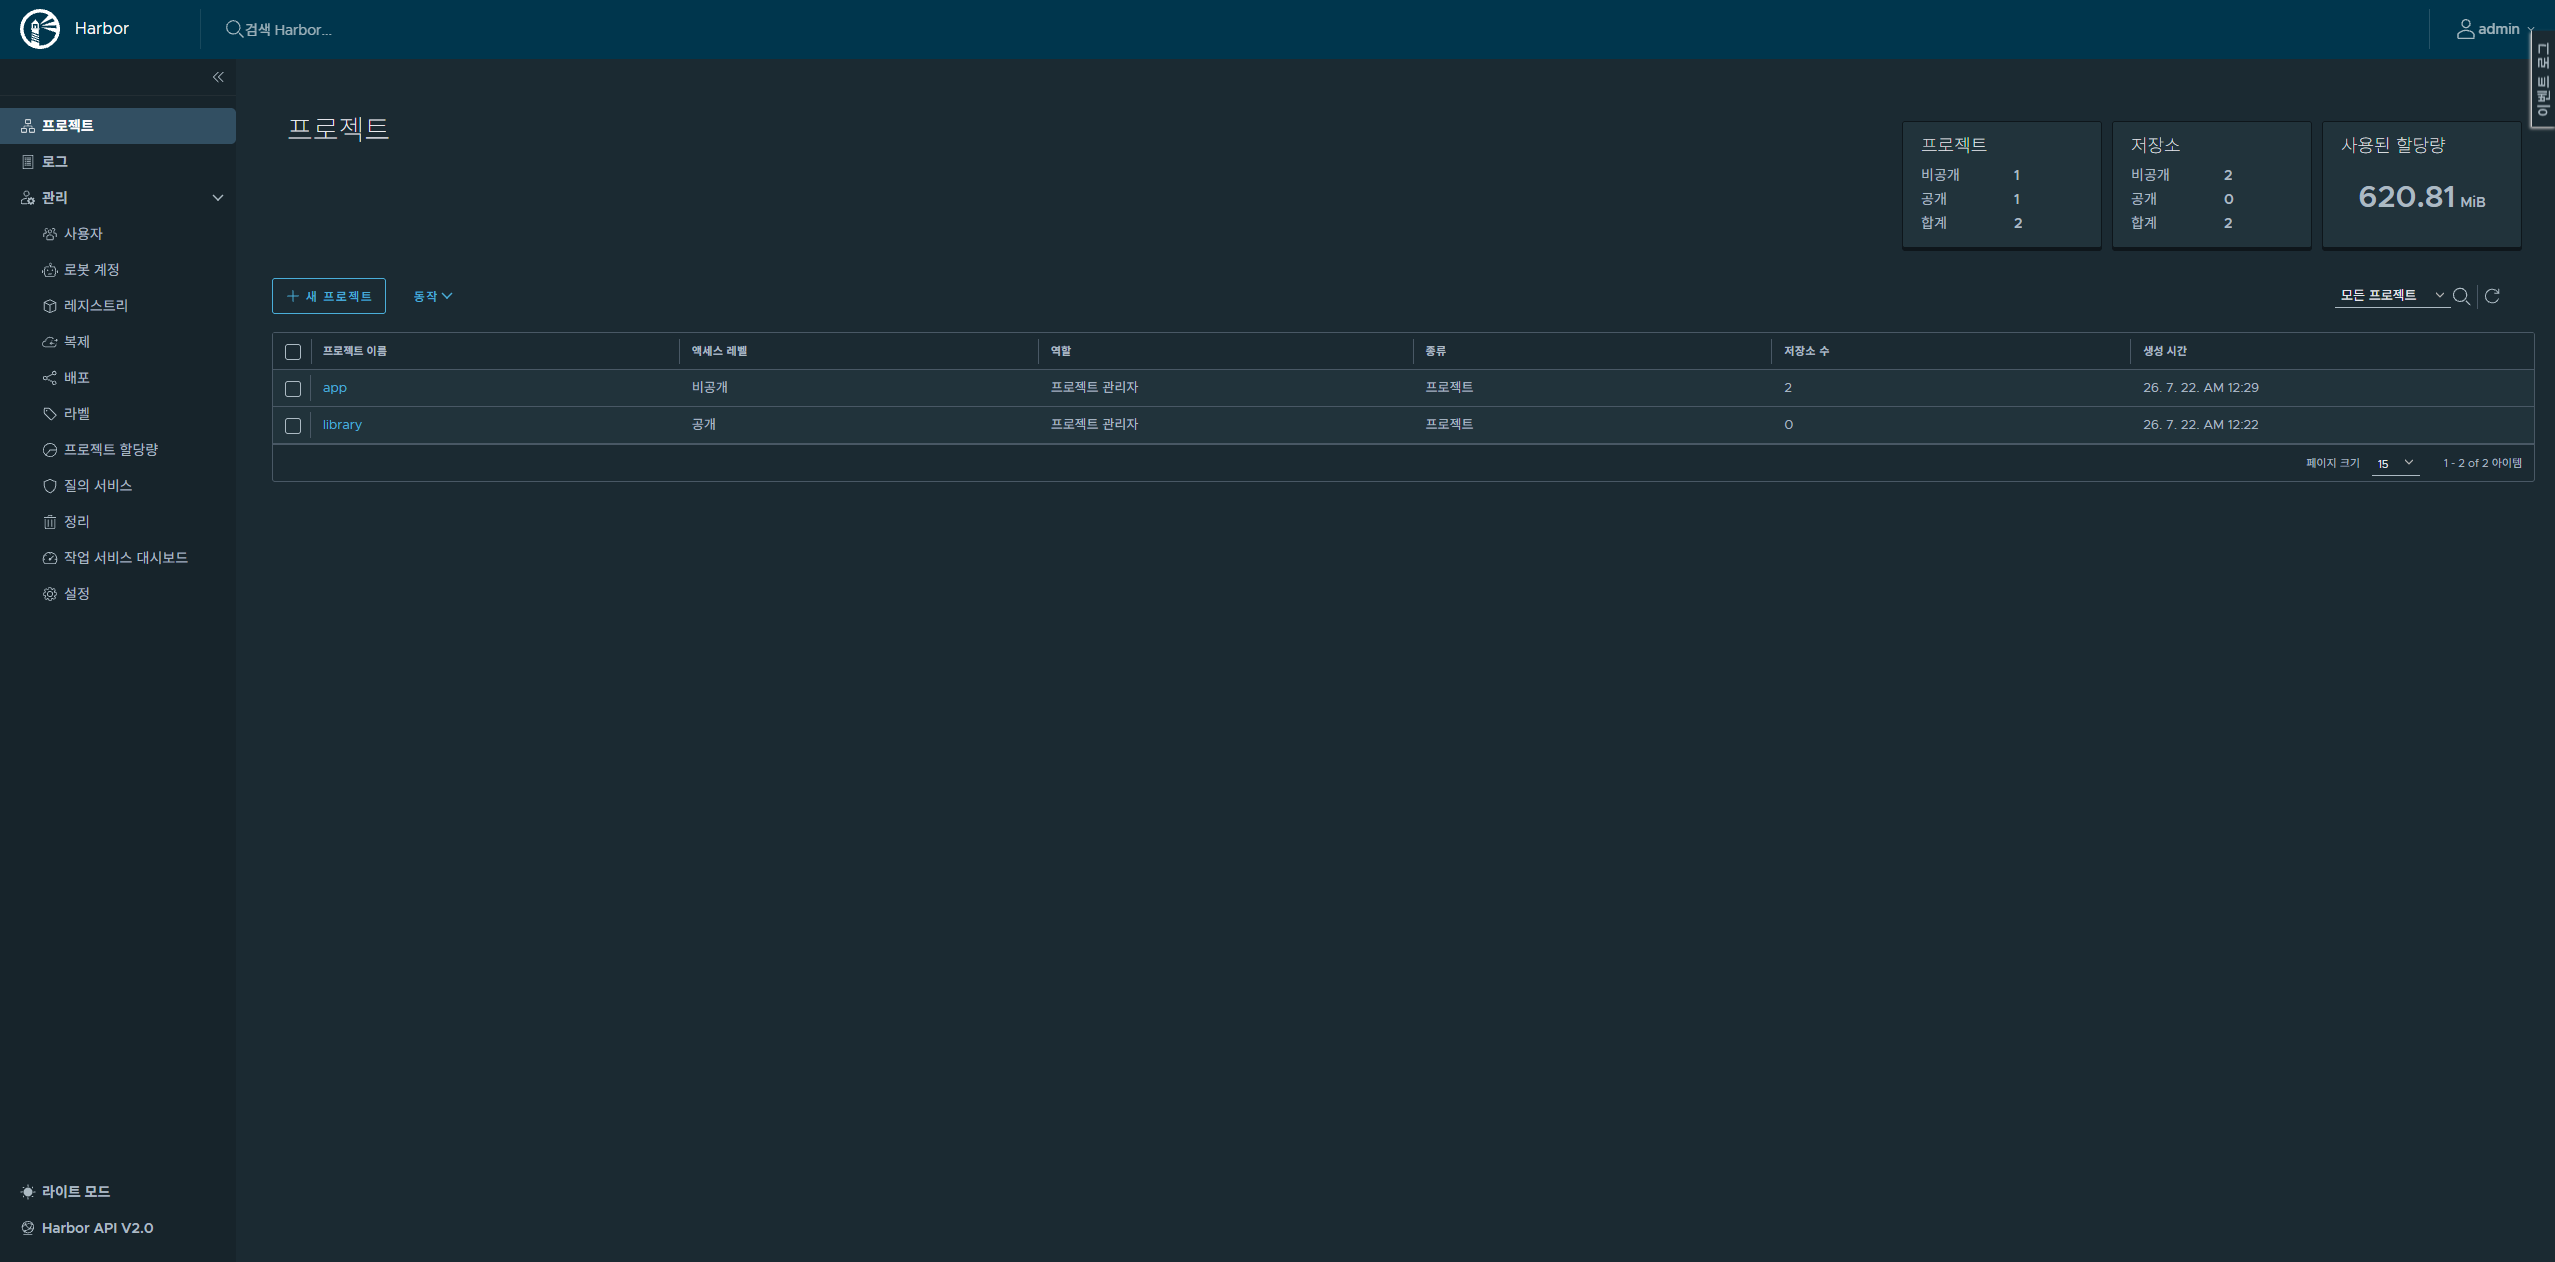
# Harbor 프로젝트별 정책 - Critical/High 취약점 발견 시 pull 자체를 차단
curl -X PUT "https://harbor.local/api/v2.0/projects/app/scanner" \
  -u admin:<password> \
  -d '{"vulnerability_prevent_pull": true, "severity": "high"}'
이 정책이 바로 ISMS-P 2.10(시스템·서비스 보안관리)에서 요구하는 "취약한 이미지의 배포를 막는 절차"에 대한 증적이 된다.
차단 기준(severity)을 어디에 둘지는 그냥 "제일 엄격한 값"을 고르는 문제가 아니다. critical만 막으면 걸리는 이미지가 거의 없어서 정책이 있는지 없는지 체감이 안 되고, 반대로 medium까지 막으면 흔한 베이스 이미지 대부분이 걸려서 배포가 사실상 멈춘다. 기준을 잡을 때 본 건 "이 파드가 외부 트래픽을 직접 받는가"였다 - api-server처럼 인그레스로 노출되는 서비스는 high 이상에서 차단하고, 클러스터 내부에서만 통신하는 배치성 워커는 critical만 막는 식으로 프로젝트(Harbor의 project 단위)마다 기준을 다르게 걸 수 있다. 외부 공격 표면이 큰 쪽일수록 기준을 더 낮게(더 엄격하게) 잡는 방향이다.
False Positive를 실무에서 다루는 방법: Trivy가 잡는 CVE 중 상당수는 "이론적으로 해당 라이브러리에 취약점이 있다"는 것뿐이지, 실제 컨테이너에서 그 취약한 함수를 호출하지도 않는 경우가 많다. 이런 걸 전부 차단 대상으로 두면 정상적인 배포까지 막혀서 팀이 정책을 우회하려는 유인이 생긴다 - 그래서 무시할 CVE는 .trivyignore에 명시적으로 등록한다.
# .trivyignore
# CVE-2023-XXXX: base image의 libssl 취약점.
# TLS termination은 ingress에서 처리하고 컨테이너 내부에서 해당 함수를 호출하지 않음
# 승인: 보안 담당자 (2026-06-01) / 재검토 예정: 2026-12-01
CVE-2023-XXXX
핵심은 CVE ID만 덜렁 적어두는 게 아니라 왜 무시하는지, 누가 승인했는지, 언제 재검토할지를 주석으로 같이 남기는 것이다. .trivyignore 변경은 개발자 단독 판단으로 머지되지 않도록 CODEOWNERS로 해당 파일에 보안 담당 리뷰어를 지정해둔다 - "이 취약점은 무시하기로 했다"는 결정도 나중에 감사(audit)할 수 있어야 예외 처리가 통제 불능으로 늘어나는 걸 막을 수 있다.
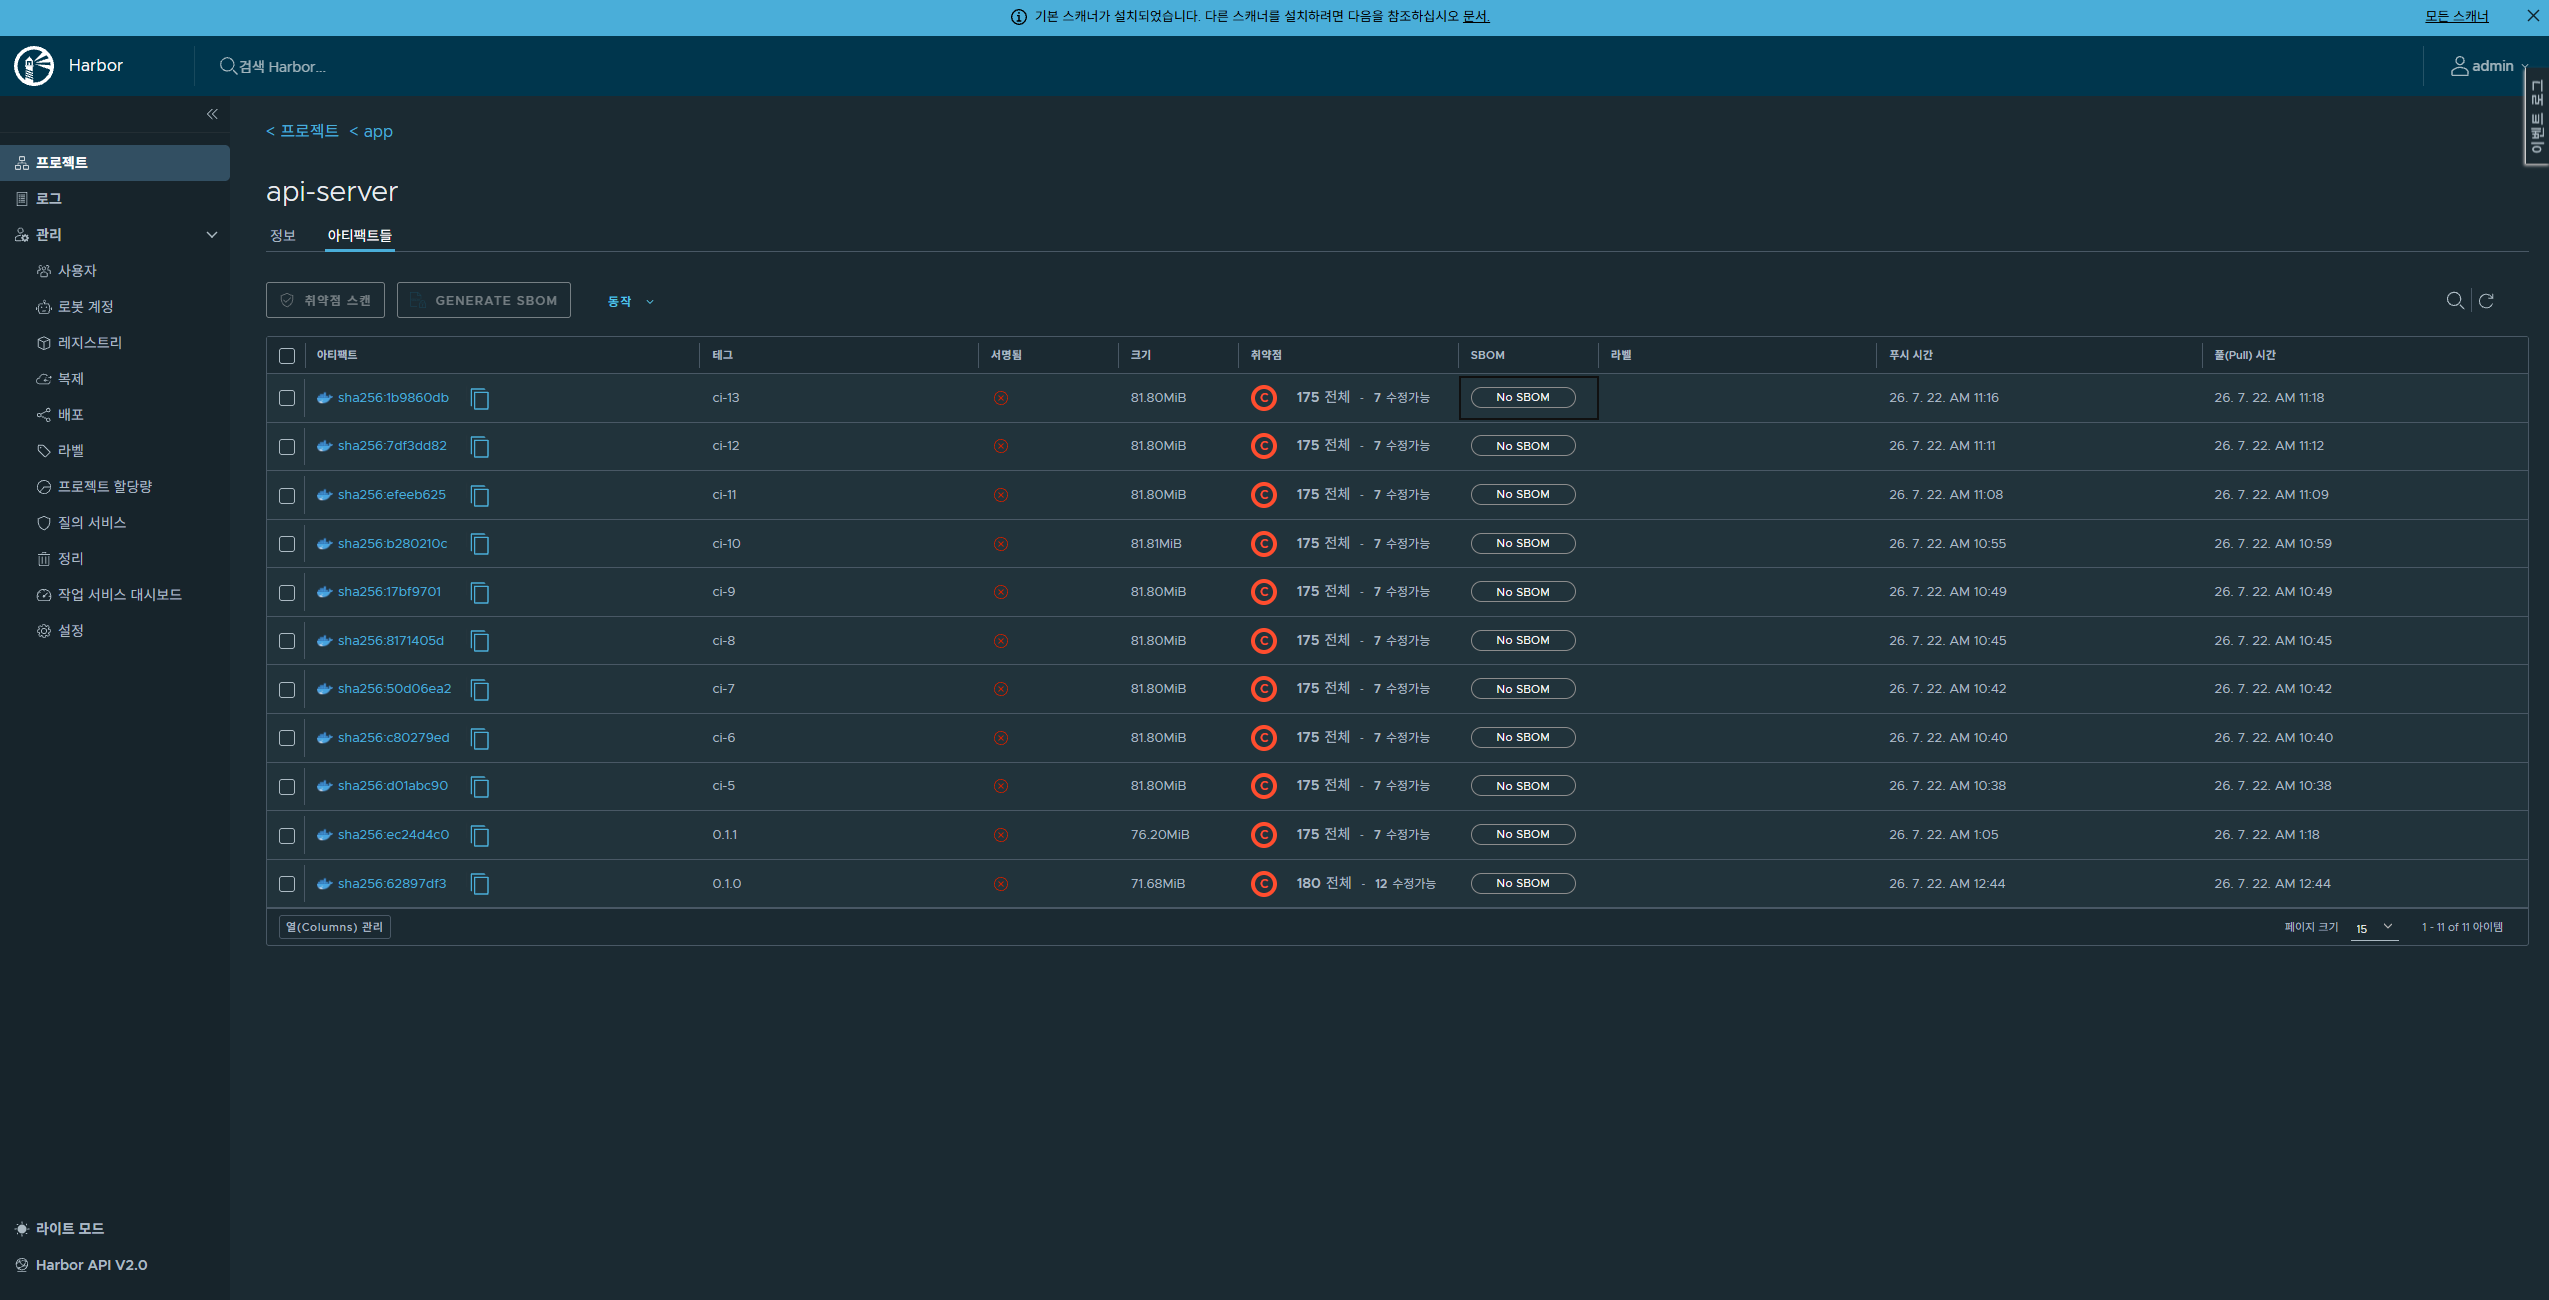
5. Jenkins - 빌드 파이프라인
CI(지속적 통합)란: 코드를 커밋할 때마다 사람이 수동으로 빌드·테스트하는 대신, 그 과정을 자동으로 실행해주는 것이다. Jenkins는 그 자동화를 실행하는 도구 중 하나로, Git 저장소의 변경을 감지해 정의된 파이프라인(빌드→테스트→이미지 생성)을 순서대로 실행한다.
// Jenkinsfile
pipeline {
  agent any
  stages {
    stage('Test') {
      steps { sh 'pytest' }
    }
    stage('Build') {
      steps {
        sh 'docker build -t harbor.local/app/api-server:${GIT_COMMIT} ./api-server'
      }
    }
    stage('Push to Harbor') {
      steps {
        sh '''
          docker login harbor.local -u $HARBOR_USER -p $HARBOR_PASS
          docker push harbor.local/app/api-server:${GIT_COMMIT}
        '''
      }
    }
    stage('Wait for Trivy Scan') {
      steps {
        // Harbor가 푸시된 이미지를 자동 스캔 - 결과가 나올 때까지 폴링
        sh '''
          harbor-cli scan wait --project app --repo api-server --tag ${GIT_COMMIT}
        '''
      }
    }
    stage('Update Manifest') {
      steps {
        sh '''
          cd k8s-manifests
          kustomize edit set image api-server=harbor.local/app/api-server:${GIT_COMMIT}
          git commit -am "deploy: api-server ${GIT_COMMIT}"
          git push
        '''
      }
    }
  }
}
Wait for Trivy Scan 스테이지가 Harbor 도입으로 추가된 부분이다 - Critical 취약점이 있으면 여기서 파이프라인이 실패하고, 매니페스트 갱신(배포 트리거)까지 진행되지 않는다. 마지막 스테이지가 핵심 - Jenkins가 클러스터에 직접 배포하지 않고, 매니페스트 저장소에 이미지 태그만 갱신해서 커밋한다. 실제 배포는 ArgoCD가 담당한다.
이 파이프라인은 한 번에 성공하지 못했다. Kubernetes 플러그인 dynamic agent, Harbor 인증, git 체크아웃 방식 등에서 트러블슈팅이 이어지면서 처음 아홉 번은 이런저런 이유로 실패했고, 열 번째 빌드부터 안정적으로 통과했다.
번외: Jenkins 대신 Argo Workflows + Argo Events로 이벤트 기반 CI를 짜보면
Jenkins를 대체하는 게 아니라 완전히 별개 네임스페이스(argo, argo-events)에 병행으로 구축해봤다 - 실무에서 본 적 있는 다른 조직의 구성(CD는 ArgoCD+OCI 레지스트리, CI는 Argo Workflows+Argo Events)을 참고해서, "이벤트 하나가 CI 파이프라인을 트리거하는 배관"을 직접 만들어보는 학습 목적이었다.
구성 요소는 세 가지다.
- EventBus - 이벤트가 오가는 내부 메시지 버스(NATS JetStream 기반). RabbitMQ가 애플리케이션 메시지를 옮기듯, 여기선 "무슨 이벤트가 발생했다"는 신호를 옮긴다.
- EventSource - 실제 이벤트를 받는 창구. GitHub push 웹훅을 받는 EventSource를 하나 만들었는데, 여기서 인증 방식이 흥미롭다 - GitHub API 토큰을 따로 발급하는 대신
webhookSecret으로 서명(HMAC) 검증만 한다. 웹훅을 보내는 GitHub 쪽 서버 IP가 고정돼 있지 않아서 보안그룹으로 발신자를 제한할 수 없는데, 그 대신 "서명이 맞는 요청만 진짜로 취급한다"는 방식으로 우회한 것이다 - Deploy Key에 최소 권한만 주는 것과 같은 결의 판단이다. - Sensor - EventBus에 이벤트가 들어오면 그걸 보고 "그래서 뭘 할지" 정의하는 부분. push 이벤트에서 커밋 메시지·브랜치·작성자를 뽑아 실제 Workflow(Argo Workflows가 실행하는 CRD 기반 파이프라인)를 만든다.
실제로 git push를 몇 번 날려보면서 이 배관이 끝까지 이어지는지 확인했다 - 처음엔 workflowtaskresults 관련 오류(exit code 64)로 실패했고, 원인을 고치고 나서야 두 번 연속 정상 완료됐다.
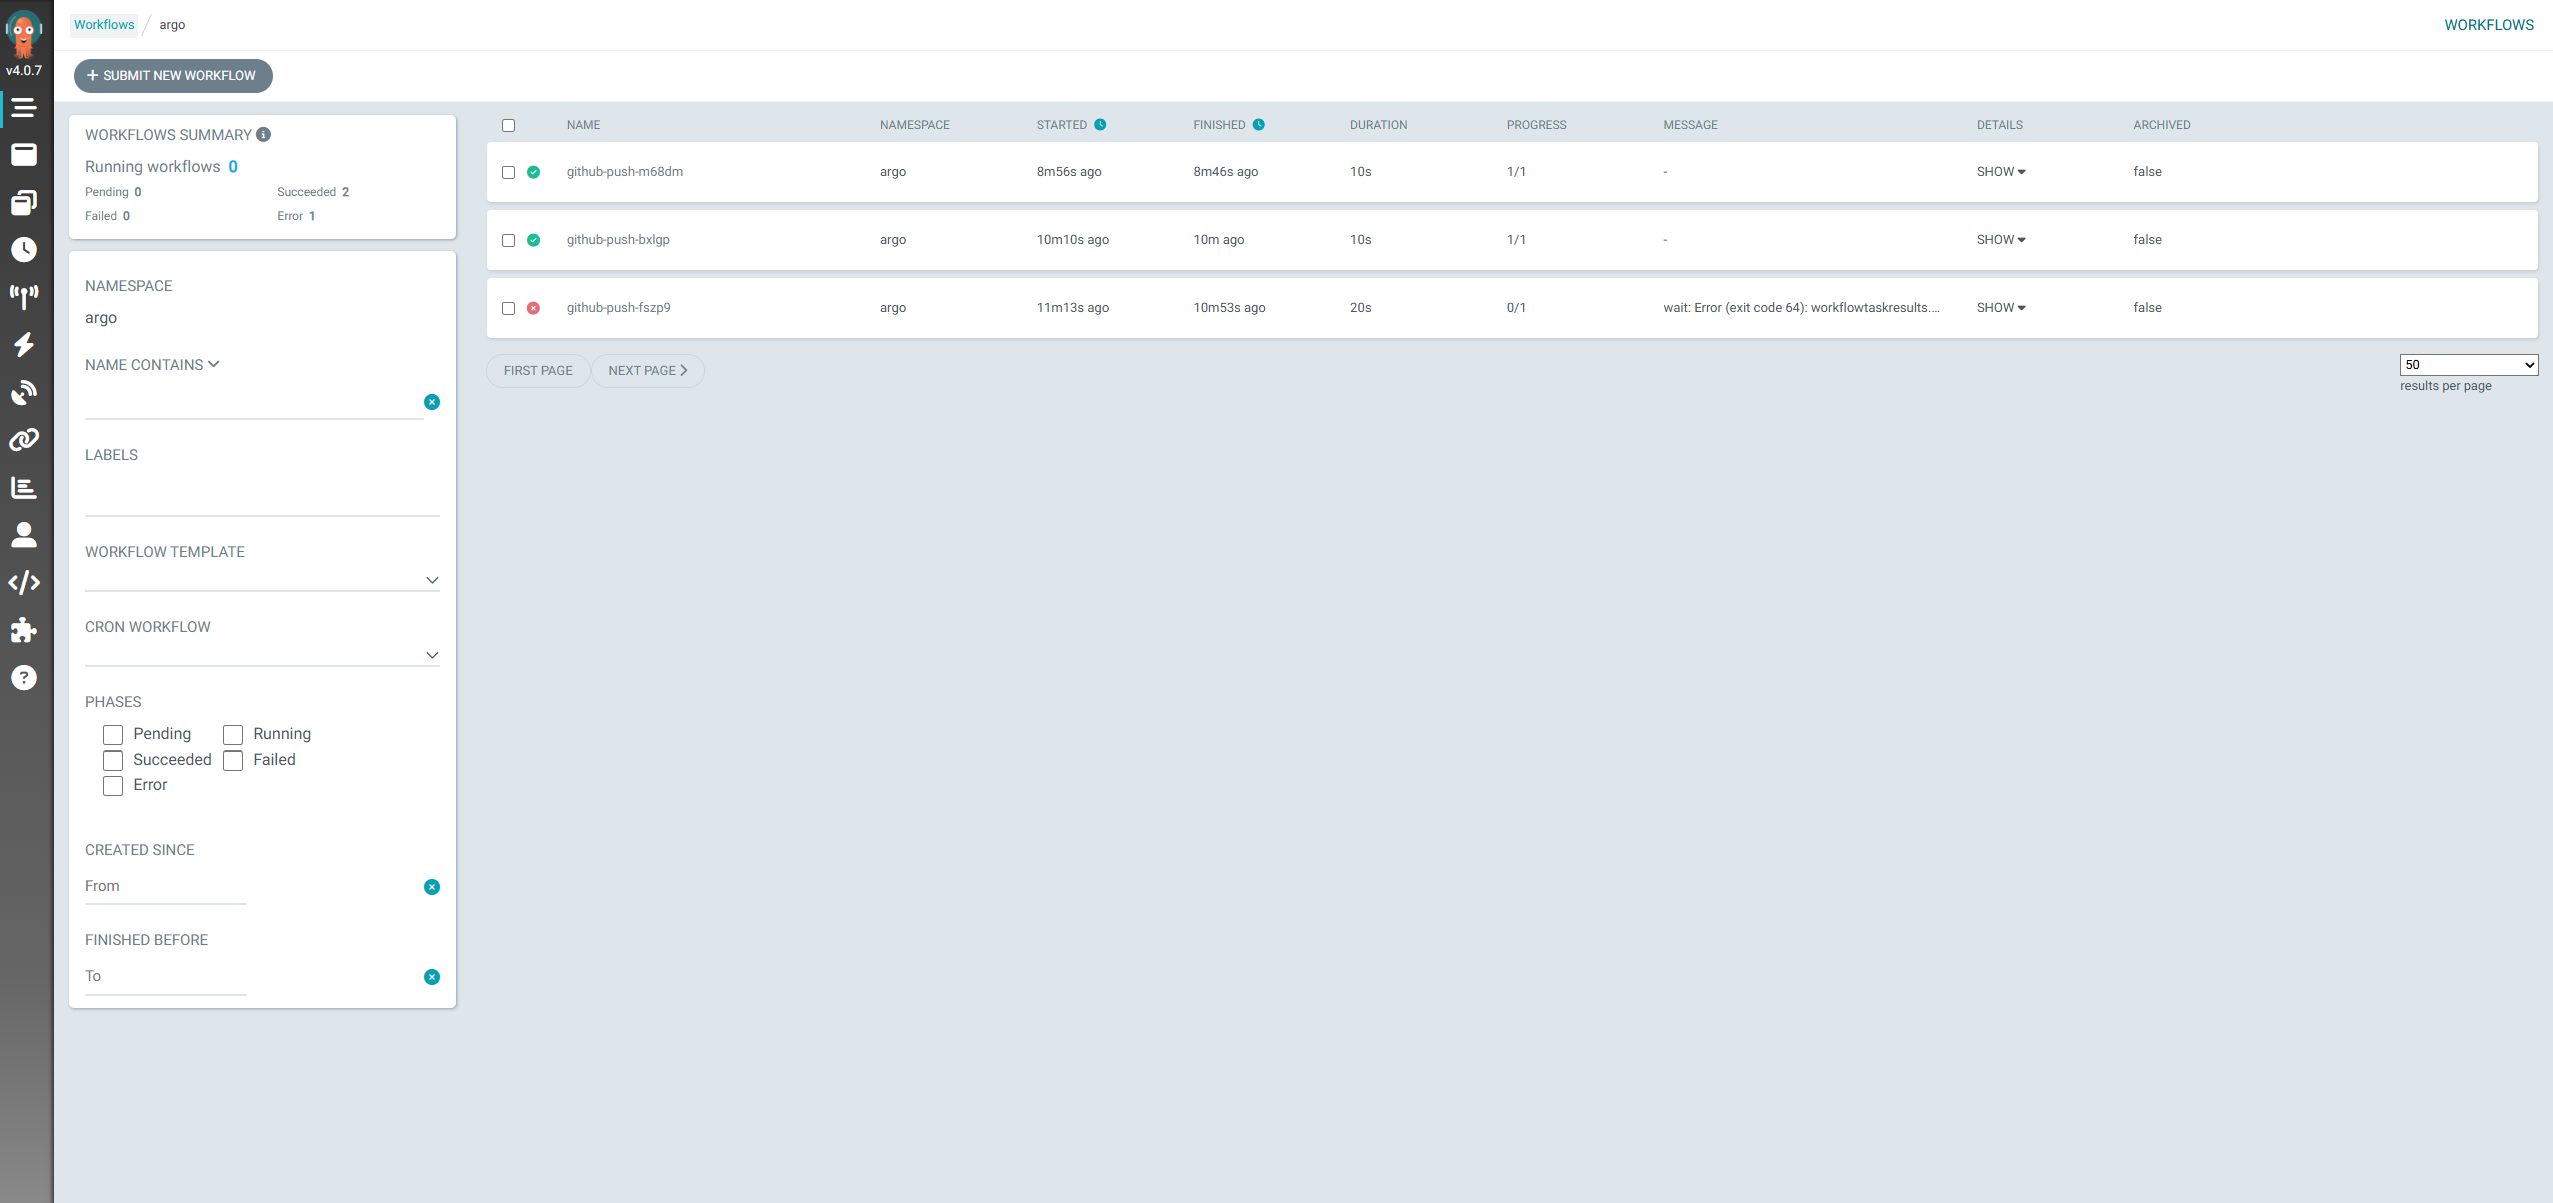
Jenkins와 비교했을 때의 실제 체감: Jenkins를 구축하며 오늘 겪은 트러블슈팅들 - SSH 자격증명이 파드 안으로 제대로 안 들어오거나, 워크스페이스 볼륨의 .git이 스테이지 사이에서 사라지거나, 같은 컨테이너를 재사용하다 빌드 산출물이 섞이는 문제 - 은 전부 "VM 시대에 만들어진 도구를 쿠버네티스 위에 얹으면서 생기는 마찰"에 가깝다. Argo Workflows는 파이프라인 자체가 처음부터 쿠버네티스 CRD라서 이런 종류의 마찰이 구조적으로 적다.
다만 이게 "그러니 Jenkins보다 항상 낫다"는 결론은 아니다. 설치 기반·생태계 규모는 Jenkins가 압도적으로 크고, Argo Workflows+Events는 원래 ML/데이터 파이프라인(Kubeflow 등) 쪽에서 더 흔히 쓰인다 - CI 용도로 쓰는 건 ArgoCD 등 Argo 생태계를 이미 깊게 쓰고 있는 조직에 더 잘 맞는 선택에 가깝다. 신규 프로젝트라면 서버 관리 자체가 필요 없는 GitHub Actions이 실무 기본값으로 더 대중적이고, 자체 인프라 CI가 꼭 필요할 만큼 k8s 투자가 이미 큰 조직에서만 Jenkins 대신 Tekton/Argo Workflows 쪽에 무게를 두는 게 현실적인 판단이다.
6. ArgoCD - GitOps 배포
CD(지속적 배포)와 GitOps란: CI가 "이미지를 만드는 것"까지라면, CD는 "그 이미지를 실제 클러스터에 반영하는 것"이다. Jenkins가 클러스터에 직접 kubectl apply를 실행하는 방식(push 배포)도 가능하지만, 그러면 "지금 클러스터에 뭐가 떠 있는지"의 유일한 근거가 Jenkins의 실행 로그뿐이게 된다. GitOps는 발상을 뒤집는다 - Git 저장소에 선언된 상태를 "정답"으로 삼고, ArgoCD가 그 정답과 클러스터의 실제 상태를 계속 비교하며 다르면 자동으로 맞춘다.
kubectl create namespace argocd
kubectl apply -n argocd -f https://raw.githubusercontent.com/argoproj/argo-cd/stable/manifests/install.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: api-server
  namespace: argocd
spec:
  project: default
  source:
    repoURL: https://git.local/k8s-manifests.git
    targetRevision: main
    path: api-server
  destination:
    server: https://kubernetes.default.svc
    namespace: app
  syncPolicy:
    automated:
      prune: true
      selfHeal: true    # 클러스터 상태가 Git과 달라지면 자동으로 되돌림
selfHeal: true가 push 배포와의 가장 큰 차이다 - 누군가 클러스터에서 리소스를 수동으로 고쳐도 ArgoCD가 Git 상태로 되돌린다.
파이프라인의 신뢰 경계 - push CI와 pull GitOps를 나눈 이유
Jenkinsfile을 다시 보면 마지막 스테이지가 kubectl apply가 아니라 "매니페스트 리포에 이미지 태그를 커밋"하는 걸로 끝난다. 이걸 그냥 스타일 차이로 넘기기 쉬운데, 실제로는 신뢰 경계(trust boundary)를 어디에 그을지에 대한 결정이다.
Jenkins가 필요로 하는 자격증명은 딱 두 가지뿐이다 - Harbor에 이미지를 푸시할 권한, 매니페스트 Git 리포에 커밋을 푸시할 권한. 클러스터 API 서버에 접근할 kubeconfig나 ServiceAccount 토큰은 전혀 필요 없다. 반면 ArgoCD는 클러스터 안에서 도는 컨트롤러라서, "클러스터에 반영할 권한"을 클러스터 밖으로 내보낼 필요가 애초에 없다 - Git 저장소를 읽어와서 스스로 반영(pull)하기 때문이다.
이 분리가 왜 중요한지는 "Jenkins가 뚫렸을 때"를 가정해보면 드러난다. Jenkins는 서드파티 플러그인, 외부에서 온 빌드 스크립트, PR로 들어온 테스트 코드 등 신뢰도가 제각각인 코드를 실행하는 시스템이라 공격 표면이 넓다. 만약 Jenkins가 push 배포 방식으로 클러스터 자격증명을 쥐고 있었다면, Jenkins 침해 = 클러스터 전체에 대한 kubectl apply 권한 탈취로 곧장 이어진다. pull 방식에서는 Jenkins가 뚫려도 공격자가 할 수 있는 최대치가 "매니페스트 리포에 잘못된 내용을 커밋하는 것"으로 제한된다 - 그마저도 브랜치 보호 규칙이나 리뷰 절차로 한 겹 더 걸러낼 수 있다.
물론 이 구조는 신뢰 경계를 없애는 게 아니라 옮기는 것이다 - 이제는 매니페스트 Git 리포 자체가 "그 리포에 머지 권한이 있으면 곧 배포 권한이 있다"는 새로운 경계가 된다. 그래서 Jenkins가 자동으로 올리는 커밋을 포함해 이 리포에는 반드시 브랜치 보호와 리뷰 절차를 걸어야 한다 - 경계를 옮겼을 뿐이지, 경계 자체를 없앤 게 아니라는 걸 놓치면 GitOps가 그냥 "권한을 아무 데나 둔 배포"로 되돌아간다.
검증 방법
argocd app get api-server           # Sync/Health 상태 확인
argocd app history api-server       # 배포 이력이 Git 커밋과 1:1로 매칭되는지 확인

# drift 감지 테스트
kubectl scale deployment api-server --replicas=5   # 수동으로 클러스터 상태 변경
argocd app get api-server           # OutOfSync로 표시되는지, selfHeal로 원래 replica 수로 돌아오는지 확인

# Harbor 취약점 차단 테스트
# 알려진 취약점이 있는 오래된 베이스 이미지로 빌드해서 푸시 → Wait for Trivy Scan 단계에서 파이프라인이 실패하는지 확인
배포 소요 시간은 git push 시점부터 argocd app get이 Synced/Healthy가 되는 시점까지를 재서 기록해둔다 - Jenkins push 배포 방식과 비교할 수치 기준이 된다.
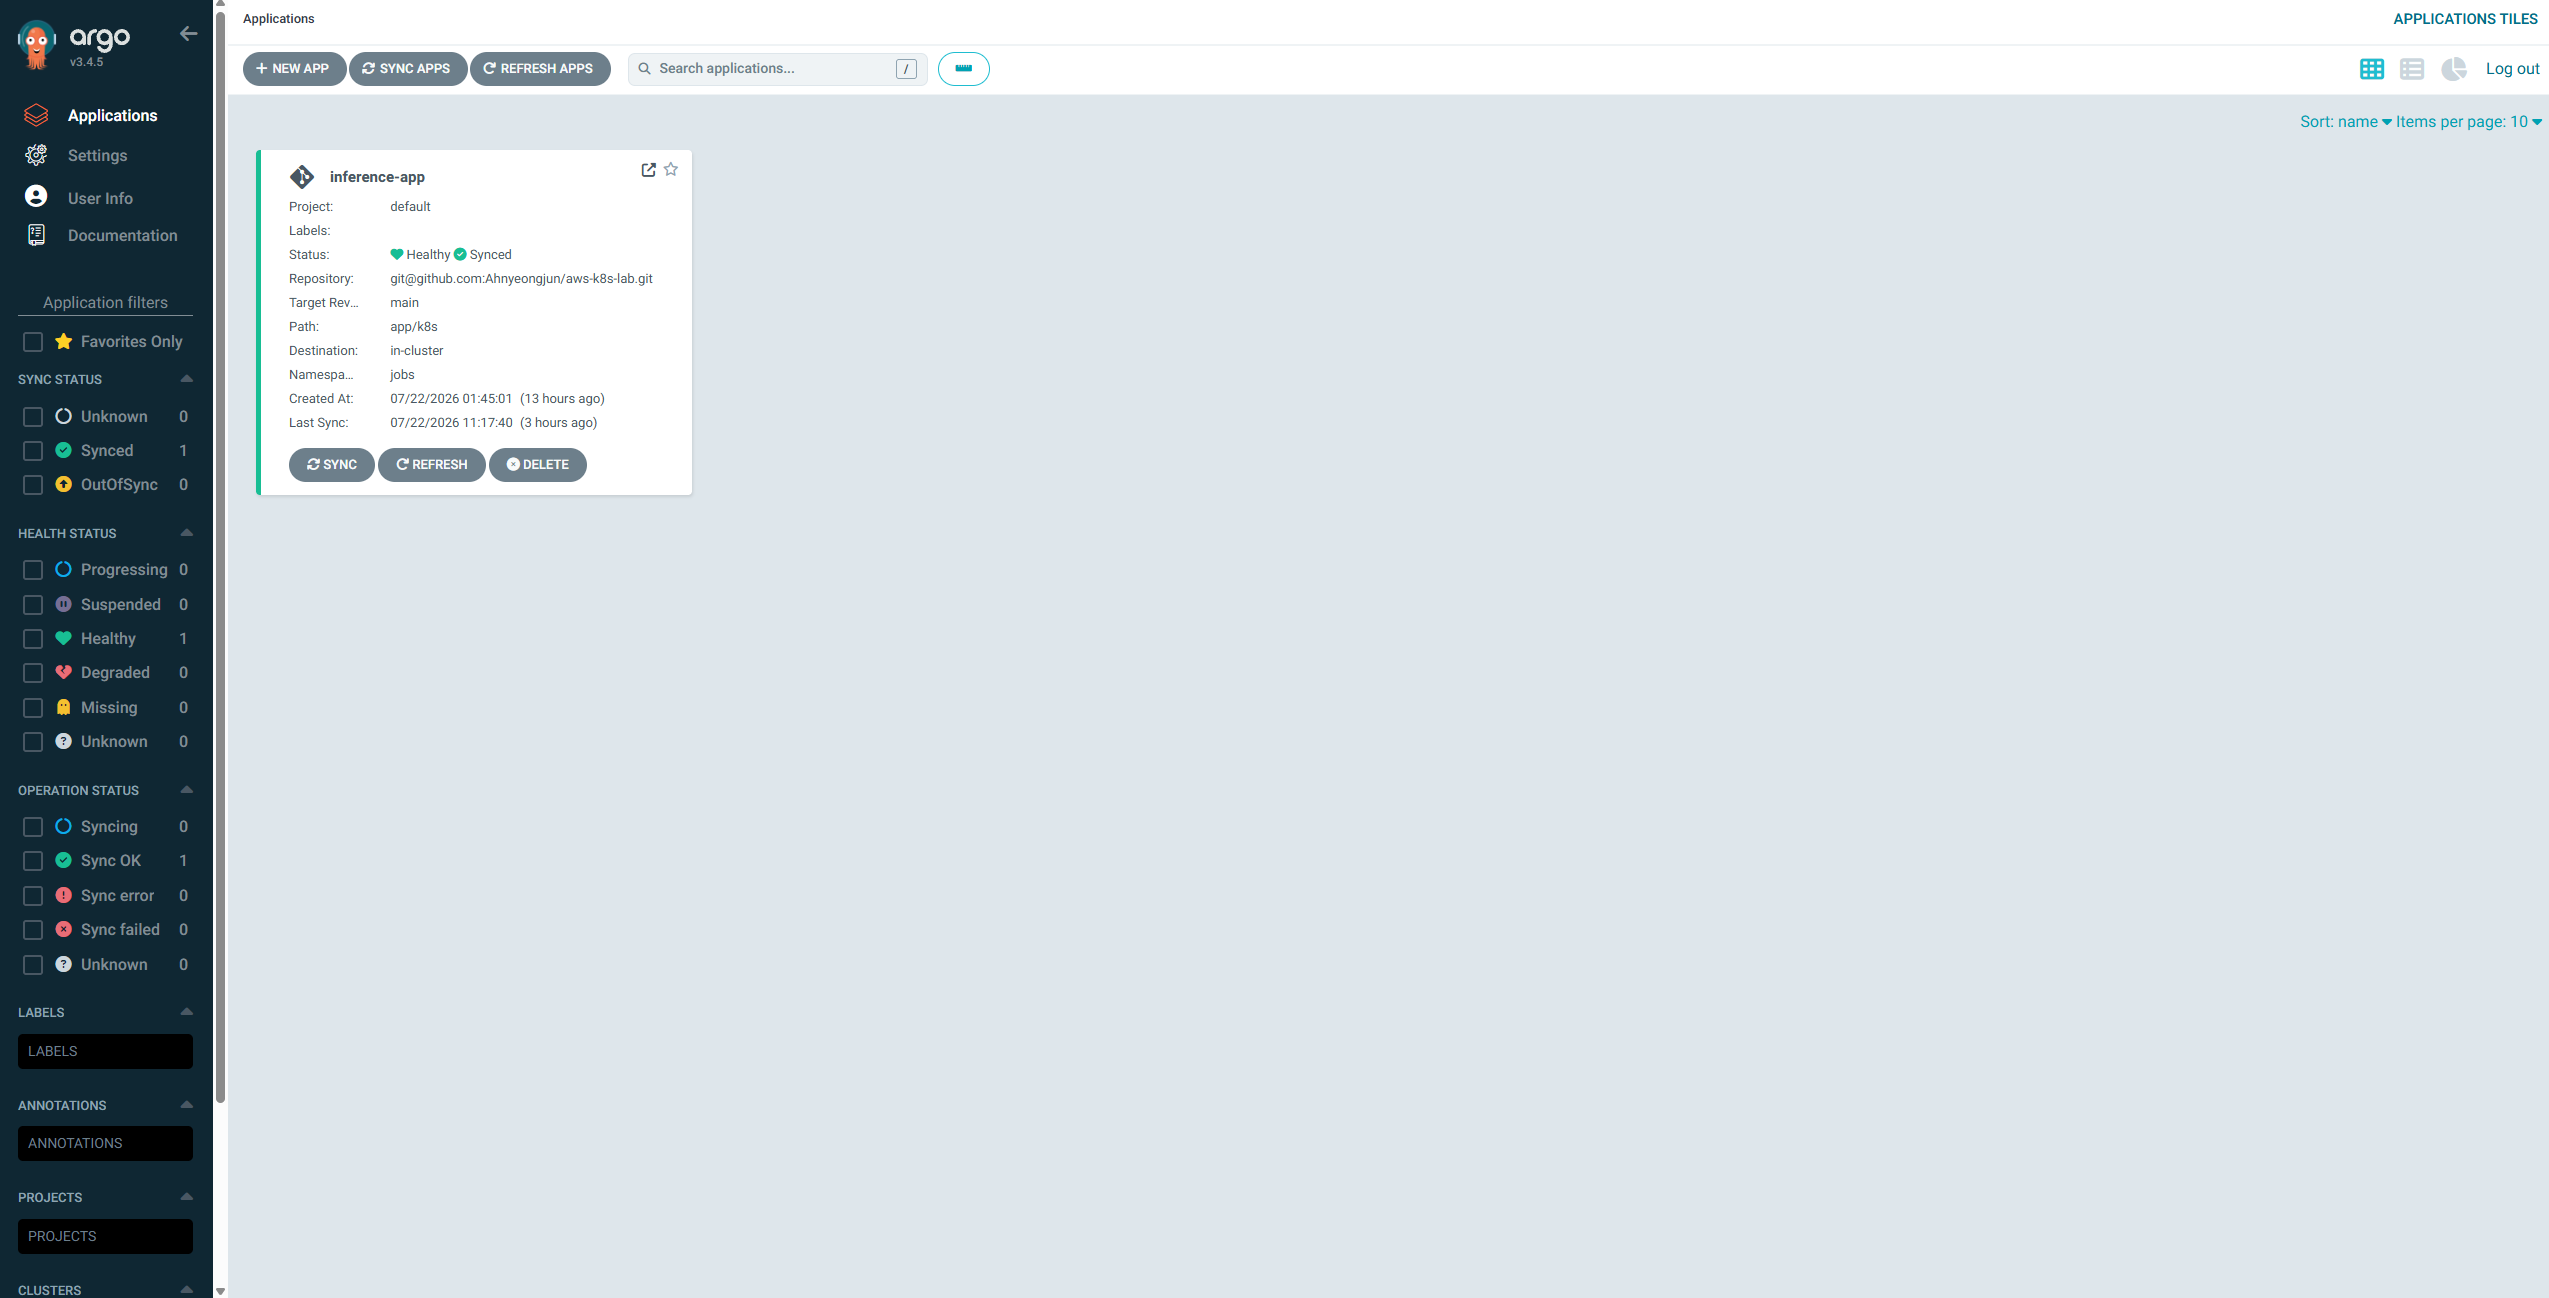
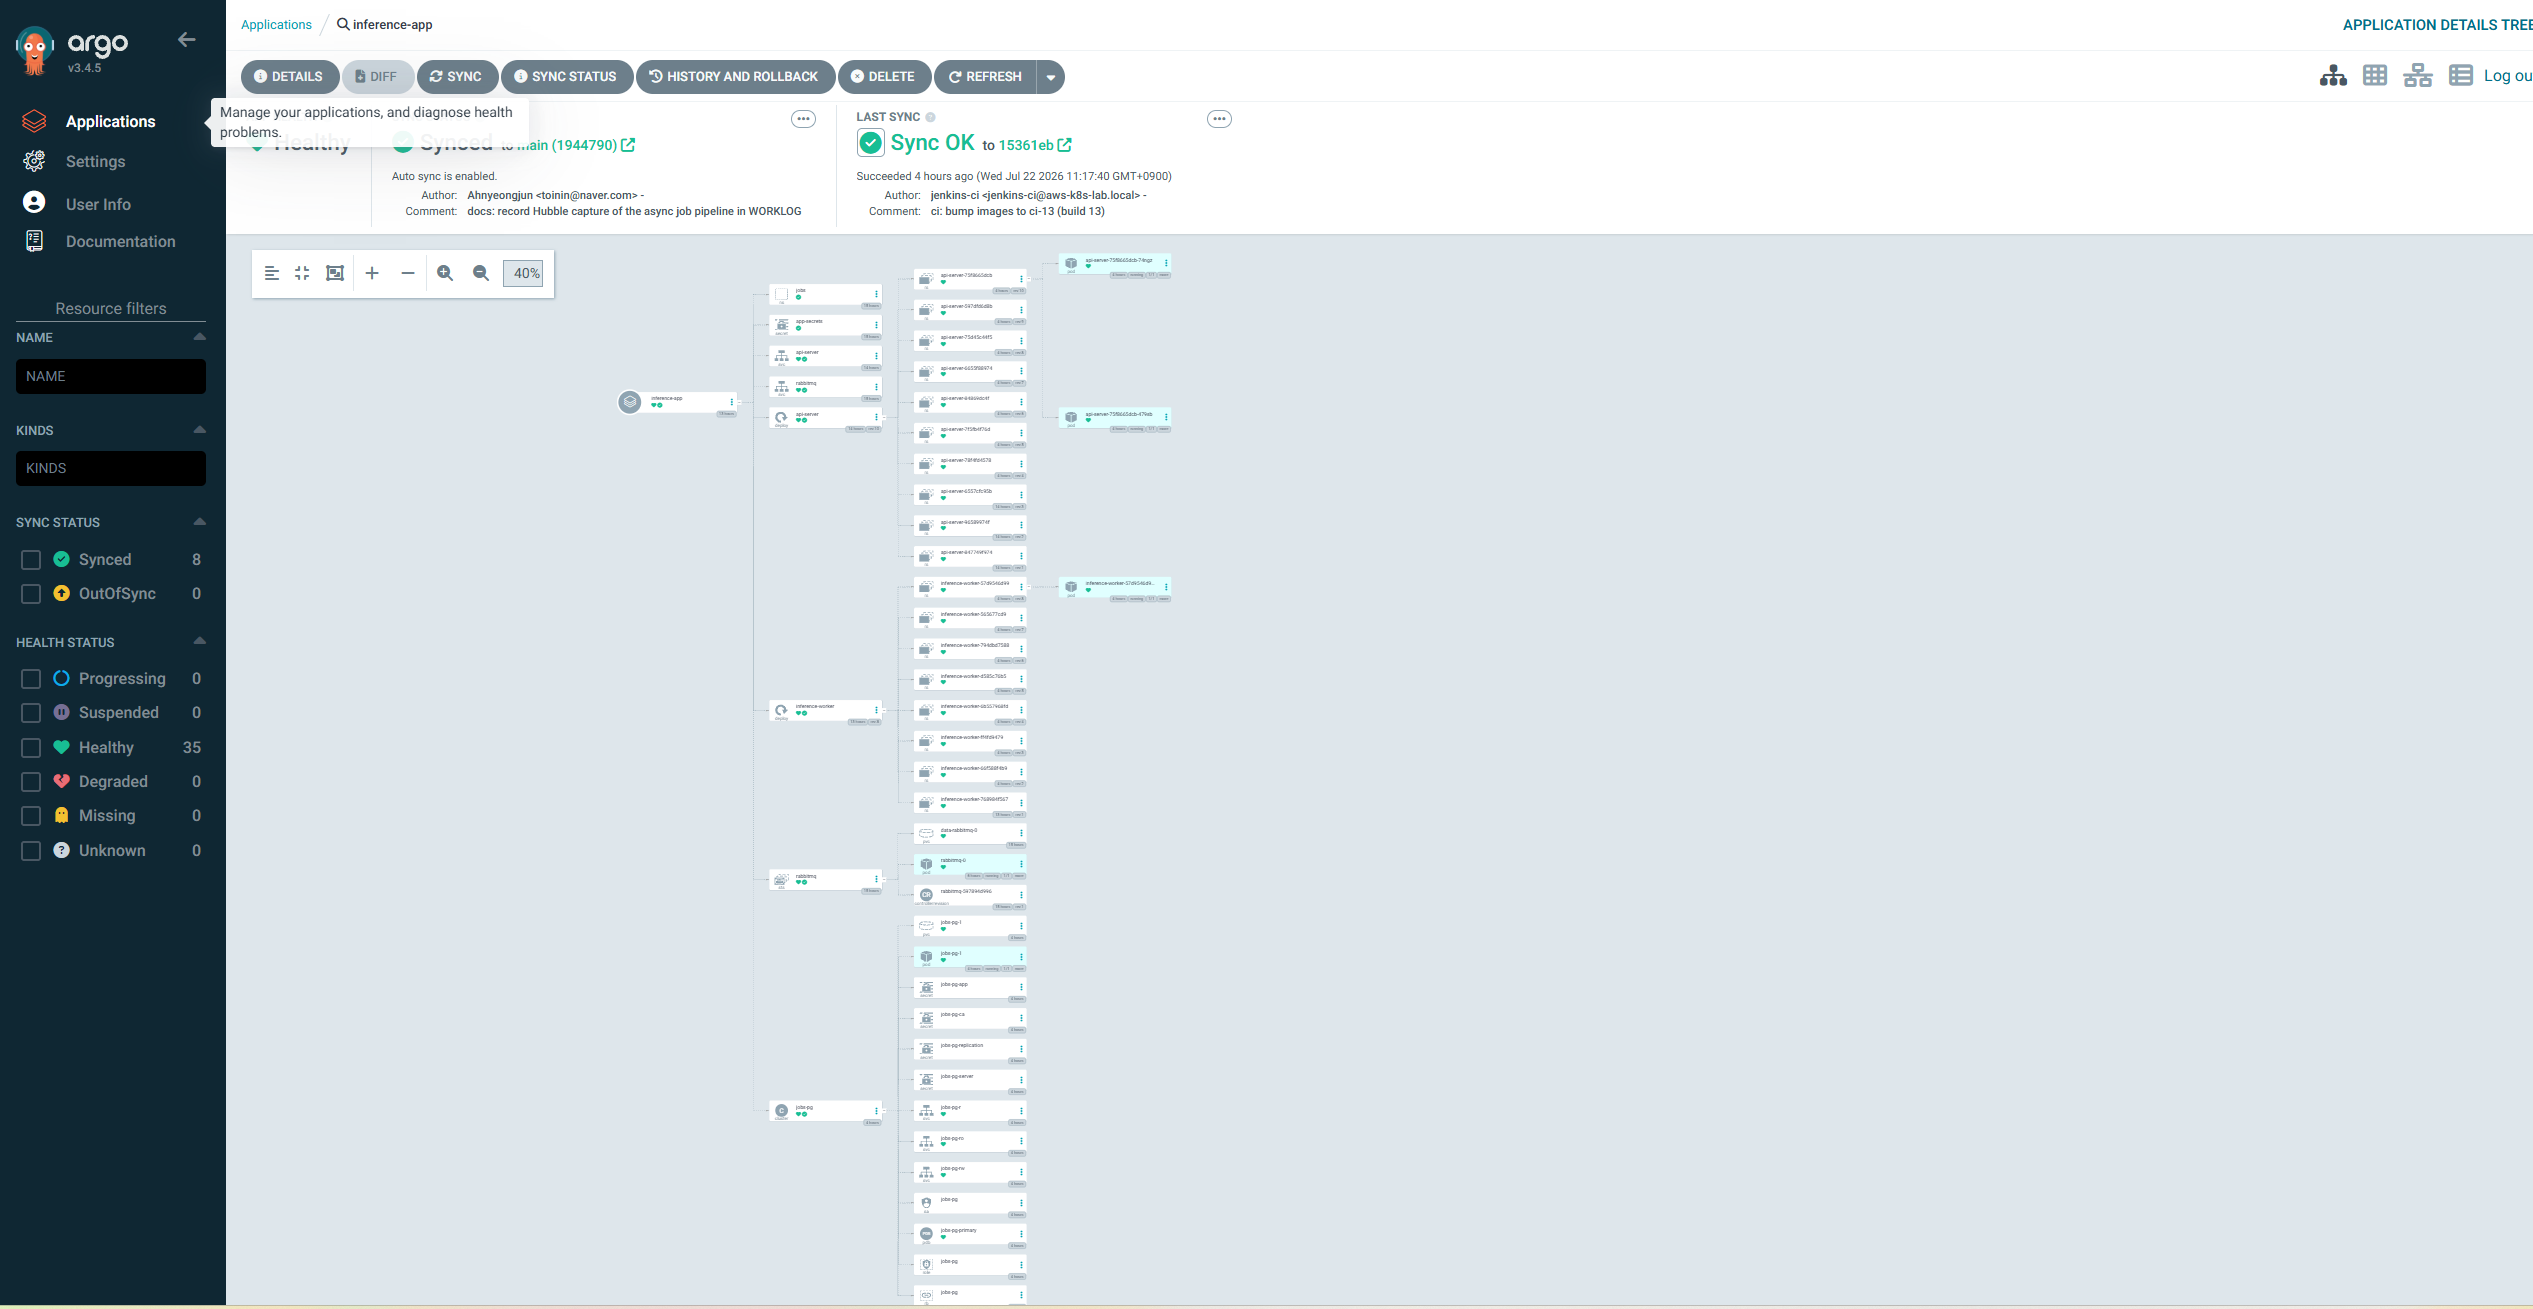
ArgoCD의 Application 상세 화면은 Git 커밋 하나가 클러스터의 어떤 리소스 트리로 펼쳐지는지, 그리고 그 커밋을 누가(사람 커밋 vs Jenkins가 이미지 태그만 갱신한 커밋) 만들었는지까지 한 화면에서 보여준다 - "지금 클러스터에 뭐가 떠 있는지"의 근거가 Jenkins 실행 로그가 아니라 Git 커밋 이력이라는 걸 실제로 확인할 수 있는 지점이다.
(선택 확장) CloudNativePG로 PostgreSQL 운영
개념: PostgreSQL을 그냥 파드 하나로 띄우면, 그 파드가 죽었을 때 자동으로 복구해주는 것도, 백업을 챙겨주는 것도 없다 - 전부 사람이 직접 만들어야 한다. CloudNativePG는 PostgreSQL 전용 Kubernetes Operator다. Operator란 "사람이 반복적으로 하던 운영 작업(장애 감지·failover 판단·백업 실행)을 대신 수행하는 컨트롤러"를 뜻한다 - Cluster라는 리소스 하나를 선언하면 그 뒤의 운영을 오퍼레이터가 대신한다.
kubectl apply -f https://raw.githubusercontent.com/cloudnative-pg/cloudnative-pg/main/releases/cnpg-1.24.0.yaml
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: app-postgres
spec:
  instances: 3          # 프라이머리 1 + 레플리카 2
  storage:
    size: 20Gi
  backup:
    retentionPolicy: "7d"
instances: 3으로 선언하는 것만으로 프라이머리가 죽었을 때 레플리카 중 하나를 자동으로 승격시키는 failover가 구성된다.
# failover 검증
kubectl cnpg status app-postgres          # 현재 프라이머리 확인
kubectl delete pod app-postgres-1 --grace-period=0 --force   # 프라이머리 강제 종료
kubectl cnpg status app-postgres          # 다른 인스턴스가 프라이머리로 승격됐는지 확인
체크리스트
- api-server, inference-worker 최소 구현 (
/healthz,/metrics표준화) - RabbitMQ StatefulSet 배포, ack/nack + DLQ(재시도 3회, 지수 백오프) 구현
- 워커 파드 강제 종료 → 메시지 재투입 검증, DLQ 격리 검증
- 멱등키(
job_id) 기반 중복 처리 방지, DLQ 메시지 개수 알람 설정 - Harbor 사설 레지스트리 구축 + Trivy 스캔 + 취약점 발견 시 배포 차단 정책
- 파드 노출 범위 기준으로 severity 차단 기준 설정,
.trivyignore예외 승인 절차(CODEOWNERS) 수립 - Jenkins 파이프라인: 빌드 → 테스트 → Harbor 푸시 → Trivy 스캔 대기
- ArgoCD 도입, GitOps 전환 - Jenkins가 클러스터 자격증명 없이 매니페스트 커밋까지만 담당하는지 확인
- 배포 소요 시간 before/after 측정
- (선택 확장) CloudNativePG로 PostgreSQL 운영 + failover 검증