kubeadm으로 온프레미스 Kubernetes 클러스터를 처음부터 세우는 절차
Kubernetes가 왜 필요한지부터, VM 2~3대 준비, kubeadm init, CNI(Calico), MetalLB, 스토리지, 그리고 선택 확장인 kube-vip HA·Cilium 마이그레이션까지 - 개념과 실제 절차·명령어 정리.
목표
VM 23대 위에 kubeadm으로 컨트롤플레인 1대 + 워커 12대 구성의 클러스터를 세운다. 여기에 CNI(Calico), LoadBalancer(MetalLB), 스토리지(NFS 또는 Longhorn)까지 붙여 "서비스를 배포할 수 있는 최소 상태"를 만드는 게 이 시리즈의 목표다. (선택 확장으로 kube-vip 컨트롤플레인 HA, Calico→Cilium 마이그레이션도 다룬다.)
개념: Kubernetes가 왜 필요한가
서버 한 대에 컨테이너 몇 개를 직접 docker run으로 띄우는 건 어렵지 않다. 문제는 서버가 여러 대이고, 그중 하나가 죽었을 때 그 위에 있던 컨테이너를 다른 서버로 옮겨야 하고, 트래픽이 늘면 컨테이너 수를 늘려야 하고, 배포할 때마다 이 모든 걸 손으로 반복해야 한다는 것이다. Kubernetes는 여러 대의 서버(노드)를 하나의 자원 풀처럼 묶어서, "컨테이너를 몇 개, 어떤 상태로 띄우고 싶다"고 선언만 하면 나머지(배치·재시작·복구)를 대신 해주는 시스템이다.
클러스터는 역할이 다른 두 종류의 노드로 나뉜다.
컨트롤플레인 (두뇌 - 무엇을 어디에 둘지 결정)
  ├─ API Server   : 모든 요청(kubectl, kubelet 등)이 지나가는 유일한 창구
  ├─ etcd         : 클러스터의 모든 상태를 저장하는 분산 DB (보통 홀수 개로 구성 - 과반수 투표로 장애 판단)
  ├─ Scheduler    : 새로 뜰 파드를 어느 워커 노드에 배치할지 결정
  └─ Controller Manager : "원하는 상태"(선언한 값)와 "실제 상태"를 계속 비교해서 맞춰나감

워커 노드 (몸 - 실제로 컨테이너가 도는 곳)
  ├─ kubelet          : 이 노드에서 컨트롤플레인의 지시대로 컨테이너를 실행·감시
  ├─ 컨테이너 런타임(containerd) : 실제로 컨테이너를 실행하는 엔진
  └─ kube-proxy        : Service로 들어온 트래픽을 알맞은 파드로 전달 (이 글 뒤쪽 Cilium 절에서 대체 이유를 다룸)
왜 관리형 Kubernetes(EKS/GKE 등)를 안 쓰고 kubeadm으로 직접 세우는가: 관리형 서비스는 컨트롤플레인 운영(etcd 백업, API 서버 이중화, 버전 업그레이드) 자체를 클라우드 사업자가 대신 해준다. 그 "대신 해주던 일"이 정확히 무엇이었는지는, 직접 컨트롤플레인을 세우고 고장 내보기 전까지는 실감하기 어렵다 - 이 시리즈의 핵심 학습 목표가 바로 그 부분이다.
사전 준비
| 항목 | 최소 사양 | 비고 |
|---|---|---|
| VM 수 | 3대 (컨트롤플레인 1 + 워커 2, 또는 1+1) | 컨트롤플레인/워커 겸용도 가능하지만 학습 목적상 분리 권장 |
| OS | Ubuntu 22.04 LTS | kubeadm 공식 지원 |
| CPU/메모리 | 컨트롤플레인 2vCPU/2GB 이상, 워커 2vCPU/4GB 이상 | |
| 네트워크 | 노드 간 통신 가능한 사설망, 고정 IP | DHCP면 고정 임대로 전환 |
| 스왑 | 비활성화 | kubelet은 기본적으로 스왑을 허용하지 않음 |
모든 노드 공통으로 사전에 처리해야 하는 것:
# 스왑 비활성화 (영구)
sudo swapoff -a
sudo sed -i '/ swap / s/^/#/' /etc/fstab

# 커널 모듈 + sysctl
cat <<EOF | sudo tee /etc/modules-load.d/k8s.conf
overlay
br_netfilter
EOF
sudo modprobe overlay
sudo modprobe br_netfilter

cat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-iptables  = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward                 = 1
EOF
sudo sysctl --system

# 컨테이너 런타임(containerd) 설치
sudo apt-get update && sudo apt-get install -y containerd
sudo mkdir -p /etc/containerd
containerd config default | sudo tee /etc/containerd/config.toml
# SystemdCgroup = false → true 로 수정
sudo sed -i 's/SystemdCgroup = false/SystemdCgroup = true/' /etc/containerd/config.toml
sudo systemctl restart containerd
overlay·br_netfilter는 왜 필요한가 - 이 둘 없으면 컨테이너도 CNI 정책도 안 된다
overlay(OverlayFS) 먼저 보면, 컨테이너 이미지는 레이어를 쌓아 만든다 - 베이스 OS 레이어 위에 패키지 설치 레이어, 그 위에 애플리케이션 코드 레이어를 얹는 식이다. 이 레이어들은 전부 읽기 전용이고, 컨테이너가 실행되면 그 위에 아주 얇은 쓰기 가능 레이어 하나만 추가된다. OverlayFS는 이 여러 레이어를 하나의 파일시스템처럼 보이게 합쳐주는 커널 기능이다.
이 구조 덕분에 같은 베이스 이미지(예: python:3.11-slim)를 쓰는 컨테이너 100개를 띄워도, 디스크에는 그 베이스 레이어가 한 벌만 존재한다 - 100개 컨테이너는 전부 그 한 벌을 읽기 전용으로 공유하고, 각자 자기 쓰기 레이어에만 변경사항을 쌓는다. 컨테이너를 지우면 그 쓰기 레이어만 사라지고 베이스는 그대로 남아 다음 컨테이너가 또 재사용한다 - 이게 이미지를 매번 통째로 복사하지 않고도 컨테이너를 가볍게 띄울 수 있는 이유다.
br_netfilter는 완전히 다른 영역이다. 리눅스 브리지(파드들을 연결하는 가상 스위치)를 통과하는 트래픽은 기본적으로 iptables/넷필터를 거치지 않는다. 브리지는 원래 "같은 스위치에 물린 장치끼리는 그냥 통과시킨다"가 기본 동작이기 때문이다.
br_netfilter 커널 모듈은 이 기본 동작을 뒤집어서, 브리지를 통과하는 트래픽도 iptables 체인을 거치게 만든다. 이 모듈이 로드되고 net.bridge.bridge-nf-call-iptables = 1이 설정돼 있어야만, kube-proxy의 Service NAT 규칙과 CNI의 NetworkPolicy가 파드 간 통신에 실제로 적용된다.
br_netfilter 없음
  파드 브리지 트래픽 → 넷필터 우회 → iptables 규칙 무의미

br_netfilter 있음
  파드 브리지 트래픽 → iptables 체인 통과 → Service NAT · NetworkPolicy 적용 가능
정리하면 overlay는 "컨테이너가 가볍게 뜰 수 있는 바닥"이고, br_netfilter는 "CNI가 정책을 걸 수 있는 바닥"이다. 둘 다 스왑 비활성화나 컨테이너 런타임 설치처럼 사전 준비 목록에 나란히 있어서 지나치기 쉽지만, br_netfilter가 빠지면 뒤에서 아무리 정교한 NetworkPolicy를 선언해도 실제로는 적용되지 않는다.
실제 구축 절차
1. kubeadm/kubelet/kubectl 설치 (모든 노드)
sudo apt-get install -y apt-transport-https ca-certificates curl gpg
curl -fsSL https://pkgs.k8s.io/core:/stable:/v1.30/deb/Release.key | \
  sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
echo 'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] \
  https://pkgs.k8s.io/core:/stable:/v1.30/deb/ /' | \
  sudo tee /etc/apt/sources.list.d/kubernetes.list
sudo apt-get update
sudo apt-get install -y kubelet kubeadm kubectl
sudo apt-mark hold kubelet kubeadm kubectl
kubeadm은 클러스터를 세우는 도구, kubelet은 각 노드에서 실제로 돌아가며 컨테이너를 관리하는 에이전트, kubectl은 사람이 클러스터에 명령을 내리는 CLI다 - 셋은 서로 다른 역할이라 세 개 다 설치해야 한다.
2. 컨트롤플레인 초기화
sudo kubeadm init \
  --pod-network-cidr=192.168.0.0/16 \
  --control-plane-endpoint="<컨트롤플레인 고정 IP 또는 VIP>:6443" \
  --upload-certs
--pod-network-cidr: Calico 기본값(192.168.0.0/16)과 맞춘다. 다른 CNI를 쓰면 그 CNI의 기본 CIDR을 확인한다.--control-plane-endpoint: 지금 당장은 컨트롤플레인 1대의 IP를 쓰되, 이후 kube-vip로 이중화할 계획이면 처음부터 VIP를 넣어두는 게 낫다 - 나중에 바꾸면 인증서를 재발급해야 한다.- 완료 후 출력되는
kubeadm join명령어(토큰 포함)를 워커 노드용으로 저장해둔다. 토큰은 24시간 후 만료되므로, 나중에 필요하면kubeadm token create --print-join-command로 재생성한다.
kubeadm init이 실패하는 가장 흔한 두 가지 원인은 이미 사전 준비 단계에서 갈린다. preflight 체크는 통과했는데도 API 서버가 안 뜨거나 kubelet이 계속 재시작을 반복한다면 대개 아래 둘 중 하나다.
| 실패 유형 | 증상 | 원인 | 확인/조치 |
|---|---|---|---|
| cgroup driver 불일치 | kubelet이 Ready로 못 올라오고 journalctl -u kubelet에 cgroup driver 관련 에러가 반복 | containerd 기본값은 cgroupfs인데 kubelet·systemd는 systemd를 기대 | /etc/containerd/config.toml의 SystemdCgroup = true 재확인 → crictl info | grep -i cgroup으로 실제 적용값 확인 |
| containerd 소켓/설정 누락 | kubeadm init이 container runtime is not running 류의 CRI preflight 에러로 중단 | containerd 설치 직후 설정을 기본값 그대로 두거나 소켓 경로가 kubelet 기대값과 다름 | systemctl status containerd로 기동 확인 → crictl --runtime-endpoint unix:///run/containerd/containerd.sock ps로 소켓 응답 확인 |
두 경우 모두 겉으로는 "API 서버가 안 뜬다"로 똑같이 보이기 때문에, 실무에서는 kubeadm init 실패 시 바로 kubectl을 의심하지 않고 먼저 journalctl -u kubelet -f와 crictl info로 컨테이너 런타임 레이어부터 확인하는 순서로 접근한다. 재시도하기 전에는 kubeadm reset으로 이전 시도의 잔여 인증서·매니페스트·iptables 규칙을 반드시 정리한다 - 정리 없이 재시도하면 이전 실패의 흔적이 새 시도에 섞여 원인 파악이 더 어려워진다.
mkdir -p $HOME/.kube
sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
sudo chown $(id -u):$(id -g) $HOME/.kube/config
3. 워커 노드 조인
sudo kubeadm join <컨트롤플레인 IP>:6443 \
  --token <토큰> \
  --discovery-token-ca-cert-hash sha256:<해시>
kubectl get nodes로 워커가 NotReady 상태로 나타나면 정상이다 - CNI가 아직 없어서 그렇다.
4. CNI 설치 - Calico
CNI(Container Network Interface)란: Kubernetes 자체는 "파드끼리 서로 다른 노드에 있어도 통신되게 만드는 방법"을 직접 구현하지 않는다. 대신 CNI라는 표준 인터페이스를 정의해두고, 그 구현은 플러그인에 맡긴다. Calico는 그 구현체 중 하나다 - CNI가 없으면 파드는 생성되지만 서로 다른 노드의 파드끼리는 통신할 방법이 없다(워커 노드가 계속 NotReady인 이유).
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.0/manifests/tigera-operator.yaml
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.0/manifests/custom-resources.yaml
custom-resources.yaml을 적용하기 전에 spec.calicoNetwork.ipPools[0].cidr 값이 kubeadm init에 넣은 --pod-network-cidr과 일치하는지 반드시 확인한다. 여기가 어긋나면 파드끼리 통신이 안 되는 문제로 이어진다.
kubectl get nodes    # 모든 노드가 Ready로 바뀌는지 확인
kubectl get pods -n calico-system
Calico의 BGP 모드 vs VXLAN(IPIP) 모드 - 온프레미스에서 뭘 골라야 하는가
Calico는 노드 간 파드 트래픽을 캡슐화 없이 그냥 라우팅으로 보낼지(BGP), 캡슐화해서 오버레이로 보낼지(VXLAN/IPIP) 선택할 수 있다. custom-resources.yaml의 spec.calicoNetwork.ipPools[0].encapsulation 값이 이 선택을 결정한다.
BGP 모드(encapsulation: None): 각 노드가 자신이 담당하는 파드 CIDR 블록을 BGP로 서로 광고한다. 패킷은 캡슐화 없이 그대로 나가고, 목적지 노드까지는 일반 IP 라우팅 테이블로 찾아간다 - 캡슐화 오버헤드가 없어 순수 처리량은 오버레이 방식보다 낫다. 다만 전제 조건이 있다: 노드들이 같은 L2 네트워크에 있거나, 상위 네트워크 장비(ToR 스위치/라우터)가 BGP를 이해하고 그 경로를 받아줘야 한다. 학습용 VM 3대가 같은 서브넷에 있는 정도라면 별도 스위치 설정 없이 노드 간 BGP(node-to-node mesh)만으로 동작한다.
VXLAN/IPIP 모드(encapsulation: VXLAN 또는 IPIP): 원본 패킷을 통째로 감싸서 노드 간에는 그냥 "이 노드로 보내는 패킷 한 개"처럼 보이게 만든다. 하위 네트워크가 파드 CIDR을 전혀 몰라도 노드끼리 IP 통신만 가능하면 동작한다 - 그만큼 하위 네트워크에 대한 요구사항이 낮다. 대가는 패킷마다 캡슐화/역캡슐화 오버헤드와 MTU 감소(VXLAN 헤더 50바이트)다.
온프레미스에서의 실무 판단: 노드가 전부 같은 스위치/서브넷에 있고 네트워크팀이 따로 없는 학습·소규모 환경이면 BGP 모드가 낫다 - 오버헤드가 없고, 문제가 생겼을 때 calicoctl node status로 BGP 피어링 상태를 직접 보고 원인을 좁힐 수 있어 디버깅도 더 명확하다. 반대로 노드가 여러 서브넷/랙에 걸쳐 있고 중간 네트워크 장비를 건드릴 권한이 없다면(랙 간 라우팅을 네트워크팀이 관리하는 경우 등) VXLAN으로 캡슐화해서 하위 네트워크에 의존하지 않는 쪽을 택한다. 클라우드 위에 온프레미스를 흉내낼 때(이 랩의 AWS 재현처럼)도 VPC 라우팅 테이블을 직접 조작할 권한이 제한적이라 VXLAN이 기본값인 이유가 여기 있다.
5. MetalLB - 온프레미스에서 LoadBalancer 타입 서비스 쓰기
클라우드에서 type: LoadBalancer 서비스를 만들면, 클라우드 사업자가 그 뒤에서 실제 로드밸런서 장비를 붙이고 외부 IP를 배정해준다. 온프레미스에는 그 역할을 해줄 사업자가 없다 - MetalLB가 그 역할을 소프트웨어로 흉내낸다.
kubectl apply -f https://raw.githubusercontent.com/metallb/metallb/v0.14.8/config/manifests/metallb-native.yaml
L2 모드(가장 단순한 구성)로 IP 풀을 지정한다.
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: default-pool
  namespace: metallb-system
spec:
  addresses:
    - 192.168.1.240-192.168.1.250   # 노드가 속한 네트워크 대역에서 안 쓰는 구간
---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: default-l2
  namespace: metallb-system
spec:
  ipAddressPools:
    - default-pool
L2 모드는 IP 풀에 속한 서비스 IP마다 클러스터 노드 중 하나를 "리더"로 선출하고, 그 리더 노드가 ARP(같은 서브넷이면)나 NDP(IPv6)로 "이 IP는 나한테 있다"고 응답하는 방식이다. 별도 라우터 설정 없이 가장 단순하게 시작할 수 있지만, 방식 자체의 한계는 실제 장애 상황에서 체감하게 된다.
| 항목 | L2 모드 | BGP 모드 |
|---|---|---|
| 동작 방식 | 서비스 IP당 리더 노드 1대가 ARP로 응답 | 모든 노드가 BGP로 라우터에 각자 경로를 광고, 라우터가 ECMP로 분산 |
| 트래픽 분산 | 안 됨 - 모든 트래픽이 리더 노드 한 대로 집중 | 됨 - 여러 노드로 실제 분산(멀티패스) |
| 요구 사항 | 없음(같은 L2 브로드캐스트 도메인이면 충분) | 상위 라우터가 BGP 피어링을 지원해야 함 |
| 장애 시 동작 | 리더 노드가 죽으면 다른 노드가 새 리더가 되어 ARP를 다시 광고 - 주변 장비의 ARP 캐시가 갱신될 때까지 수 초 단위 끊김 발생 | 라우터가 BGP 세션 타임아웃(기본 hold time은 수십 초 단위지만 BFD를 함께 쓰면 서브초 단위로 단축 가능)을 감지하면 해당 경로를 즉시 제외 - 나머지 경로로 끊김 없이 지속 |
이 프로젝트에서 L2 모드로 강제 노드 종료를 실험해보면, 서비스 자체는 몇 초 내로 복구되지만 그 몇 초 동안은 명확히 트래픽이 끊긴다 - ARP가 원래 "누가 이 IP를 가졌는지"를 브로드캐스트로 다시 물어보고 캐시를 갱신하는 데 시간이 걸리는 프로토콜이라는 걸 감안하면 당연한 결과다. 온프레미스에서 라우터가 BGP를 지원하고 네트워크팀이 피어링 설정을 열어줄 수 있는 환경이라면 BGP 모드가 가용성과 트래픽 분산 양쪽에서 우월하다 - 이 랩은 라우터 설정 권한이 없는 학습 환경이라는 전제로 L2를 택했지만, 실무 판단 기준은 "L2는 어디서나 되는 최소 옵션, BGP는 네트워크 장비 협조가 가능할 때의 정답"이라는 걸 이해하고 고른 선택이다.
이 랩을 AWS EC2 위에서 그대로 돌려보면 MetalLB가 왜 안 먹히는가
이 시리즈는 온프레미스 VM 기준으로 쓰여 있지만, 실제로는 AWS EC2 위에 VM 3대를 올려서 그대로 재현해봤다. 그런데 MetalLB L2 모드를 위 설정 그대로 적용하면 두 가지가 어긋난다.
- L2/ARP가 VPC에서 아예 동작하지 않는다. AWS의 소프트웨어 정의 네트워크(VPC)는 ENI에 명시적으로 할당되지 않은 임의의 IP에 대한 ARP 응답·브로드캐스트 자체를 허용하지 않는다. 온프레미스에서 통하던 "노드 중 하나가 ARP로 대신 응답한다"는 방식이 성립하는 전제(같은 물리 스위치의 브로드캐스트 도메인)가 VPC에는 없다.
- IP 풀 대역이 파드 CIDR과 충돌한다. 위 예시의
192.168.1.240-250은 Calico 기본 파드 CIDR192.168.0.0/16안에 포함된다 - 온프레미스 튜토리얼 자료를 그대로 복사했을 때 흔히 걸리는 함정이다.
AWS에서의 실무 정답은 MetalLB가 아니라 애초에 다른 도구 조합이다. 클라우드에서는 type: LoadBalancer Service를 실제 로드밸런서(NLB/ALB)로 프로비저닝해주는 AWS Load Balancer Controller와, 그 로드밸런서 주소를 Route 53 도메인에 자동으로 연결해주는 ExternalDNS를 함께 쓰는 게 일반적이다. MetalLB 하나가 하던 "가짜 클라우드 LB 역할"을, AWS에서는 이 두 컨트롤러가 "실제 LB 프로비저닝 + 실제 DNS 연결"로 나눠서 맡는 셈이다. MetalLB를 굳이 학습 목적으로 실습하려면 L2 대신 BGP 모드로 바꾸거나, 아예 AWS 네이티브 조합으로 갈아타야 한다.
6. 스토리지 - NFS 또는 Longhorn
파드는 기본적으로 상태가 없다 - 파드가 재시작되면 그 안에 쓴 파일도 함께 사라진다. DB처럼 데이터를 유지해야 하는 워크로드는 파드 바깥의 별도 저장소에 데이터를 두고, 파드가 그걸 마운트해서 쓴다. PersistentVolumeClaim은 "이 정도 용량과 특성의 저장공간을 달라"는 요청서고, StorageClass는 그 요청을 실제 저장소 구현(NFS/Longhorn 등)에 연결해주는 설정이다.
여기서 처음 나오는 Helm은 뭔가: Kubernetes 리소스는 보통 여러 개의 yaml(Deployment, Service, ConfigMap...)로 흩어져 있는데, Helm은 이걸 "차트(chart)"라는 패키지 하나로 묶어 설치·업그레이드·삭제까지 명령 한 줄로 처리하게 해주는 패키지 매니저다 - apt/npm의 Kubernetes 버전이라고 보면 된다. helm repo add는 차트 저장소를 등록하는 것이고, helm install이 그 저장소의 차트를 실제로 클러스터에 설치하는 명령이다. 이 시리즈 전반에서 nfs-provisioner·Longhorn·Cilium 같은 복잡한 컴포넌트를 매번 yaml 여러 개를 손으로 짜지 않고 Helm으로 설치하는 이유가 이것이다.
NFS (더 단순, 단일 장애점 있음): 별도 NFS 서버(또는 노드 중 하나)에 nfs-kernel-server를 띄우고, nfs-subdir-external-provisioner를 Helm으로 설치해 StorageClass를 등록한다.
helm repo add nfs-subdir-external-provisioner https://kubernetes-sigs.github.io/nfs-subdir-external-provisioner/
helm install nfs-provisioner nfs-subdir-external-provisioner/nfs-subdir-external-provisioner \
  --set nfs.server=<NFS 서버 IP> \
  --set nfs.path=/exported/path
Longhorn (분산 블록 스토리지, 복제 지원): 노드마다 데이터가 복제되므로 노드 하나가 죽어도 볼륨이 살아있다는 이점이 있다. 대신 각 노드에 open-iscsi 등 의존성 설치가 필요하다.
helm repo add longhorn https://charts.longhorn.io
helm install longhorn longhorn/longhorn --namespace longhorn-system --create-namespace
두 개 중 하나만 고르면 된다 - 이 프로젝트 규모에서는 NFS로 시작해도 충분하고, 이후 노드 장애 실험(시리즈 6)에서 스토리지 복제가 필요하다고 판단되면 Longhorn으로 바꾼다.
검증 방법
kubectl get nodes -o wide                     # 전 노드 Ready
kubectl get pods -A | grep -v Running         # Running이 아닌 파드가 없어야 정상
kubectl apply -f - <<EOF
apiVersion: v1
kind: Service
metadata:
  name: test-lb
spec:
  type: LoadBalancer
  selector: {app: nonexistent}
  ports: [{port: 80}]
EOF
kubectl get svc test-lb                       # EXTERNAL-IP가 MetalLB 풀에서 할당되는지 확인
kubectl delete svc test-lb
스토리지는 PersistentVolumeClaim을 하나 만들어 Bound 상태로 전환되는지 확인한다.
흔한 실패와 트러블슈팅
클러스터를 몇 번 부수고 다시 세워보면(체크리스트의 "파괴 후 재구축") 실제로 반복해서 만나는 실패는 크게 두 갈래다. 관리형 K8s만 다뤄봤다면 이 중 어느 것도 겪을 일이 없다 - 이 부분이 "직접 겪어본 사람"과 "안 겪어본 사람"을 가르는 지점이다.
워커 노드가 NotReady에서 안 넘어갈 때 - 세 가지 다른 원인
kubectl get nodes에서 NotReady 하나만 보고는 원인을 알 수 없다. kubectl describe node <노드>의 Conditions 항목까지 봐야 구분된다.
| 증상 | 원인 | 확인 방법 |
|---|---|---|
KubeletNotReady: network plugin is not ready: cni config uninitialized | CNI 매니페스트를 아예 적용하지 않음 | ls /etc/cni/net.d/ - 파일이 없으면 이 케이스 |
Ready 조건은 True인데 파드가 계속 Pending/ContainerCreating에 머무름 | CNI 파드(calico-node 등) 자체가 CrashLoopBackOff | kubectl get pods -n calico-system으로 CNI 파드 상태 확인 - "설치는 됐지만 정상 기동은 못한" 상태 |
| CNI 파드는 Running인데 파드 간 통신만 안 됨(같은 노드 안에서는 되는데 노드를 넘어가면 안 됨) | --pod-network-cidr과 CNI 쪽 IP 풀 CIDR 불일치 | kubectl get ippools -o yaml(Calico) 값과 kubeadm init에 넣은 CIDR을 나란히 비교 |
세 번째가 가장 잘 안 걸린다 - 노드는 Ready로 뜨고 CNI 파드도 Running이라 겉으로는 "정상"처럼 보이기 때문이다. "같은 노드 안 파드끼리는 되는데 노드를 넘어가면 안 된다"는 증상이 CIDR 불일치의 특징적인 신호다.
etcd 쿼럼이 깨졌을 때
컨트롤플레인을 3대로 구성했을 때(뒤의 kube-vip HA 절), etcd 멤버 3개 중 2개 이상이 살아있어야 과반수 투표가 성립해서 클러스터가 쓰기 요청(파드 생성, 스케줄링 등)을 처리할 수 있다. 3개 중 2개가 죽으면 남은 1개로는 과반수를 만들 수 없어 클러스터 전체가 사실상 정지한다.
증상: kubectl 명령이 전부 context deadline exceeded 또는 etcdserver: request timed out 에러로 멈춘다. 읽기 전용 조회(kubectl get)는 캐시된 응답이 남아있는 짧은 시간 동안은 되는 것처럼 보일 수 있지만, 쓰기 요청은 즉시 실패한다.
# 각 컨트롤플레인 노드에서 etcd 멤버 상태 확인
sudo ETCDCTL_API=3 etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  endpoint health --cluster
복구 절차: 죽은 멤버가 되살릴 수 있는 노드라면(재부팅 등) 그 노드를 복구해서 기존 데이터 디렉터리로 다시 합류시키는 게 가장 빠르다. 노드 자체가 완전히 사라졌다면(디스크 손실 등) 살아있는 멤버 쪽에서 그 멤버를 쿼럼에서 명시적으로 제거해야 한다 - 죽은 멤버를 방치하면 남은 멤버 수 기준으로 과반수 계산이 계속 잘못된 채로 남는다.
# 살아있는 멤버 목록에서 죽은 멤버의 ID 확인 후 제거
sudo etcdctl member list
sudo etcdctl member remove <죽은 멤버 ID>
그 다음 새 컨트롤플레인 노드를 kubeadm join --control-plane으로 추가해서 멤버 수를 다시 홀수로 맞춘다. 이 흐름 전체는 뒤의 "컨트롤플레인 노드 교체 절차"와 동일하다.
etcd 백업/복구
etcd는 클러스터의 유일한 상태 저장소다 - Deployment, Secret, ConfigMap, RBAC 정책까지 전부 여기 있다. etcd가 완전히 사라지면 클러스터를 "복구"하는 게 아니라 "처음부터 다시 만드는" 것과 다름없어진다. 그래서 정기 백업은 선택이 아니라 컨트롤플레인 운영의 기본이다.
왜 항상 홀수 개로 구성하는가
etcd는 Raft 합의 알고리즘으로 동작하고, 쓰기가 성립하려면 전체 멤버 중 **과반수(majority)**의 동의가 필요하다. 멤버 수와 "몇 대까지 죽어도 버틸 수 있는가"의 관계를 보면 홀수가 왜 유리한지 바로 보인다.
| 멤버 수 | 과반수 | 허용 가능한 장애 대수 |
|---|---|---|
| 2 | 2 | 0 (1대만 죽어도 과반수 불성립) |
| 3 | 2 | 1 |
| 4 | 3 | 1 (3대와 동일 - 자원만 더 씀) |
| 5 | 3 | 2 |
4대는 3대보다 노드를 하나 더 쓰면서도 허용 장애 대수는 3대와 똑같다 - 짝수는 "한 대 더 버틸 것 같지만 실제로는 아무 이득이 없는" 구성이다. 그래서 실무에서는 짝수를 선택지에 넣지 않고 3대(소규모) 또는 5대(대규모)로만 구성한다.
정기 백업 - etcdctl snapshot save
sudo ETCDCTL_API=3 etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  snapshot save /backup/etcd-snapshot-$(date +%Y%m%d-%H%M).db

# 스냅샷 자체가 정상인지는 반드시 확인 - 손상된 백업은 없는 것보다 위험하다(복구 시점에야 발견됨)
sudo ETCDCTL_API=3 etcdctl --write-out=table snapshot status /backup/etcd-snapshot-*.db
실무에서는 이 명령을 cron/systemd timer로 매일(또는 변경 빈도에 맞춰 더 자주) 돌리고, 스냅샷 파일을 etcd가 도는 노드 로컬이 아니라 별도 저장소(S3, NFS 등)로 즉시 옮긴다 - 로컬에만 두면 그 노드가 통째로 사라지는 장애에서는 백업도 같이 사라진다.
복구 절차
# 1. kube-apiserver, etcd 등 static pod를 잠시 내린다 (매니페스트를 다른 경로로 옮기면 kubelet이 자동으로 내림)
sudo mv /etc/kubernetes/manifests /etc/kubernetes/manifests.bak

# 2. 스냅샷으로부터 새 데이터 디렉터리를 복원
sudo ETCDCTL_API=3 etcdctl snapshot restore /backup/etcd-snapshot-20260810-0200.db \
  --data-dir /var/lib/etcd-restored

# 3. etcd static pod 매니페스트의 데이터 디렉터리 경로를 restored 경로로 수정한 뒤 다시 배치
sudo mv /etc/kubernetes/manifests.bak /etc/kubernetes/manifests
복구는 "그 시점 이후의 모든 변경을 잃는다"는 걸 전제로 한다 - 스냅샷 이후 생성된 리소스, 변경된 Secret 등은 되돌아오지 않는다. 그래서 백업 주기가 곧 "장애 시 최대 몇 시간의 작업을 잃을 수 있는가"를 결정한다.
컨트롤플레인 노드 교체 절차
노드 하나가 완전히 죽어서 교체해야 할 때는 새 노드를 무작정 join시키기 전에 죽은 멤버를 etcd 쿼럼에서 먼저 빼야 한다 - 안 그러면 쿼럼 계산에 죽은 멤버가 계속 끼어서 과반수 산정이 왜곡된다.
- 살아있는 멤버에서
etcdctl member list로 죽은 노드의 멤버 ID 확인 etcdctl member remove <ID>로 쿼럼에서 제거- 죽은 노드가
kubectl get nodes목록에도 남아있으면kubectl delete node <노드명>으로 정리 - 새 노드를
kubeadm join --control-plane으로 추가 (1단계에서 저장해둔--certificate-key재사용, 만료됐으면 컨트롤플레인 노드에서kubeadm init phase upload-certs --upload-certs로 재발급) etcdctl member list로 새 멤버가 정상 합류했는지, 멤버 수가 다시 홀수인지 확인
이 절차를 안 지키고 그냥 새 노드를 join시키면, 옛 멤버가 쿼럼에 남은 채로 새 멤버가 추가되어 오히려 과반수 성립 조건이 더 어려워지는 경우가 실제로 생긴다.
(선택 확장) kube-vip로 컨트롤플레인 3노드 HA
개념: 컨트롤플레인이 1대뿐이면, 그 노드가 죽는 순간 클러스터 전체를 조작할 방법이 사라진다 - kubectl도 안 되고, 새 파드 스케줄링도 멈춘다. 컨트롤플레인을 3대로 늘리면 etcd가 과반수(3개 중 2개) 투표로 정상 여부를 판단하기 때문에 1대가 죽어도 나머지 둘로 유지된다. 문제는 "3대 중 지금 어디로 접속해야 하는가"다 - 특정 노드의 IP를 그대로 쓰면 그 노드가 죽었을 때 접속 주소 자체가 사라진다.
kube-vip는 3대 앞에 **고정된 가상 IP(VIP)**를 두고, 살아있는 노드 중 하나가 리더 선출(leader election)로 그 VIP를 응답하도록 자동으로 넘겨준다. 클라이언트(kubectl, 워커의 kubelet 등)는 항상 같은 VIP로만 접속하면 된다.
아래 매니페스트의 vip_arp: true가 바로 이 리더 선출 결과를 실제 네트워크에 반영하는 방식이다 - 새로 리더가 된 노드가 ARP로 "이 VIP는 나한테 있다"고 광고한다. MetalLB의 L2 모드와 원리가 완전히 같고, 한계도 같다: VIP를 응답하는 노드와 그 VIP에 접속하는 클라이언트가 같은 L2 브로드캐스트 도메인에 있어야 한다. 컨트롤플레인 3대가 서로 다른 서브넷/랙에 걸쳐 있으면 ARP 기반 VIP 자체가 성립하지 않는다.
# /etc/kubernetes/manifests/kube-vip.yaml (각 컨트롤플레인 노드에 동일하게 배치 - static pod)
apiVersion: v1
kind: Pod
metadata:
  name: kube-vip
  namespace: kube-system
spec:
  containers:
    - name: kube-vip
      image: ghcr.io/kube-vip/kube-vip:v0.8.0
      args: ["manager"]
      env:
        - {name: vip_arp, value: "true"}
        - {name: address, value: "<VIP>"}
        - {name: vip_interface, value: "eth0"}
        - {name: cp_enable, value: "true"}
        - {name: cp_namespace, value: "kube-system"}
      securityContext:
        capabilities: {add: ["NET_ADMIN", "NET_RAW"]}
      volumeMounts:
        - {name: kubeconfig, mountPath: /etc/kubernetes/admin.conf}
  hostNetwork: true
  volumes:
    - {name: kubeconfig, hostPath: {path: /etc/kubernetes/admin.conf}}
컨트롤플레인 노드 2·3대째는 kubeadm join --control-plane(1단계에서 --upload-certs로 받은 인증서 키 사용)으로 추가한다.
sudo kubeadm join <VIP>:6443 \
  --token <토큰> \
  --discovery-token-ca-cert-hash sha256:<해시> \
  --control-plane --certificate-key <upload-certs 키>
ARP 방식의 한계와 대안 - BGP 모드, 외부 로드밸런서
kube-vip는 ARP 모드 대신 BGP 모드(bgp_enable: true)도 지원한다 - 각 컨트롤플레인 노드가 상위 라우터에 VIP 경로를 직접 광고하고, 리더가 바뀌면 광고를 갱신한다. L2 제약이 없어져서 노드가 서로 다른 서브넷에 있어도 되고, 장애 전환도 ARP 캐시 갱신을 기다리는 것보다 보통 더 예측 가능하다. 다만 온프레미스 라우터가 BGP를 지원하고 피어링 설정 권한이 있어야 한다는 전제는 MetalLB BGP 모드와 동일하다.
또 다른 대안은 kube-vip를 아예 안 쓰고, API 서버 앞에 별도의 로드밸런서(HAProxy, 또는 사내에 이미 있는 L4 LB 장비)를 두는 것이다. HAProxy를 별도 VM(컨트롤플레인 노드와 무관한 독립 노드)에 띄우고, 백엔드로 컨트롤플레인 3대의 :6443을 등록해서 헬스체크로 살아있는 노드로만 라우팅한다.
| 방식 | 장점 | 단점 |
|---|---|---|
| kube-vip (ARP) | 추가 인프라 없음, 컨트롤플레인 노드 자체가 LB 역할 겸용 | 같은 L2에 있어야 함, 전환 시 수 초 끊김 |
| kube-vip (BGP) | L2 제약 없음, 컨트롤플레인 노드가 LB 역할 겸용 | 라우터 BGP 지원·피어링 권한 필요 |
| 외부 LB (HAProxy 등) | L2/BGP 제약 전혀 없음, LB 자체를 이중화하면 더 견고 | LB용 별도 인프라(및 그 자체의 이중화)가 추가로 필요 - "누가 LB를 감시하는가" 문제가 한 겹 더 생김 |
이 프로젝트에서는 컨트롤플레인 노드 자체를 LB로 겸용해 추가 인프라를 늘리지 않는 kube-vip ARP 모드를 택했다 - VM 3대가 이미 같은 서브넷에 있어 L2 제약이 걸림돌이 안 됐기 때문이다. 노드가 여러 네트워크에 걸치는 환경이었다면 외부 LB나 kube-vip BGP 모드로 갔을 것이다.
검증 실험 - 컨트롤플레인 1대 강제 종료:
# 리더 역할을 하고 있는 컨트롤플레인 노드를 강제 종료
sudo shutdown -h now

# 다른 노드에서 확인할 것
kubectl get nodes                 # VIP를 통한 kubectl 접속이 계속 되는지
kubectl -n kube-system get pods -l component=etcd   # 남은 etcd 멤버들이 여전히 정상인지
# 죽은 노드를 되살린 뒤 etcd에 다시 합류하는지도 확인
(선택 확장) Calico → Cilium 마이그레이션
개념: CNI는 교체 가능한 표준 인터페이스이므로, 다른 구현체로 바꿀 수 있다(다만 무중단 교체는 까다로워 보통 재구축이 안전하다). 이 교체가 왜 의미 있는지 이해하려면 먼저 kube-proxy가 하는 일을 알아야 한다 - kube-proxy는 Service가 생성·변경될 때마다 모든 노드의 iptables 규칙을 다시 계산해서 갱신하는 방식으로 트래픽을 라우팅한다. 서비스·노드 수가 늘어날수록 이 규칙 갱신 자체가 부하가 된다.
Cilium은 eBPF(리눅스 커널 안에서 안전하게 실행되는 프로그램)를 기반으로 하는 CNI로, kube-proxy가 iptables로 하던 일을 커널 레벨에서 직접 처리해 더 빠르고, L3/L4뿐 아니라 L7(HTTP 경로·메서드 단위)까지 네트워크 정책을 걸 수 있다.
# 기존 Calico 제거 (재구축 권장 - 무중단 교체는 리스크가 큼)
kubectl delete -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.0/manifests/custom-resources.yaml
kubectl delete -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.0/manifests/tigera-operator.yaml

# Cilium 설치 (kube-proxy 완전 대체 모드)
helm repo add cilium https://helm.cilium.io/
helm install cilium cilium/cilium --version 1.16.0 \
  --namespace kube-system \
  --set kubeProxyReplacement=true \
  --set k8sServiceHost=<컨트롤플레인 IP 또는 VIP> \
  --set k8sServicePort=6443
cilium status                 # kube-proxy replacement가 "True"로 뜨는지 확인
cilium connectivity test      # 파드 간 통신, 정책 적용이 정상인지 종합 검증
iptables와 eBPF, 실제로 뭐가 다른가
kube-proxy가 iptables로 Service 라우팅을 처리하는 방식은 규칙 체인 순회다. 패킷 하나가 들어올 때마다 등록된 규칙을 위에서부터 순서대로 대조한다 - Service·엔드포인트가 늘어날수록 패킷 하나를 처리하는 데 확인해야 할 규칙 수도 함께 늘어난다.
eBPF는 다르다. 커널 안에 작은 프로그램을 심어서, 패킷을 해시맵 조회 한 번으로 목적지를 찾는다. 규칙(서비스) 개수가 늘어나도 조회 비용이 거의 일정하다. kubeProxyReplacement=true로 Cilium이 kube-proxy를 완전히 대체하면, Service 라우팅 자체가 iptables 체인을 아예 거치지 않고 이 경로로 처리된다.
여기에 더해 iptables는 L3/L4(IP·포트) 단위까지만 본다. Cilium은 eBPF 프로그램이 애플리케이션 계층 프로토콜(HTTP)까지 파싱할 수 있어서, "이 파드는 호출 가능하지만 DELETE /admin/*은 안 된다" 같은 L7 정책도 같은 계층에서 표현할 수 있다 - 이게 CNI를 Calico에서 Cilium으로 바꾸는 실질적인 이유다.
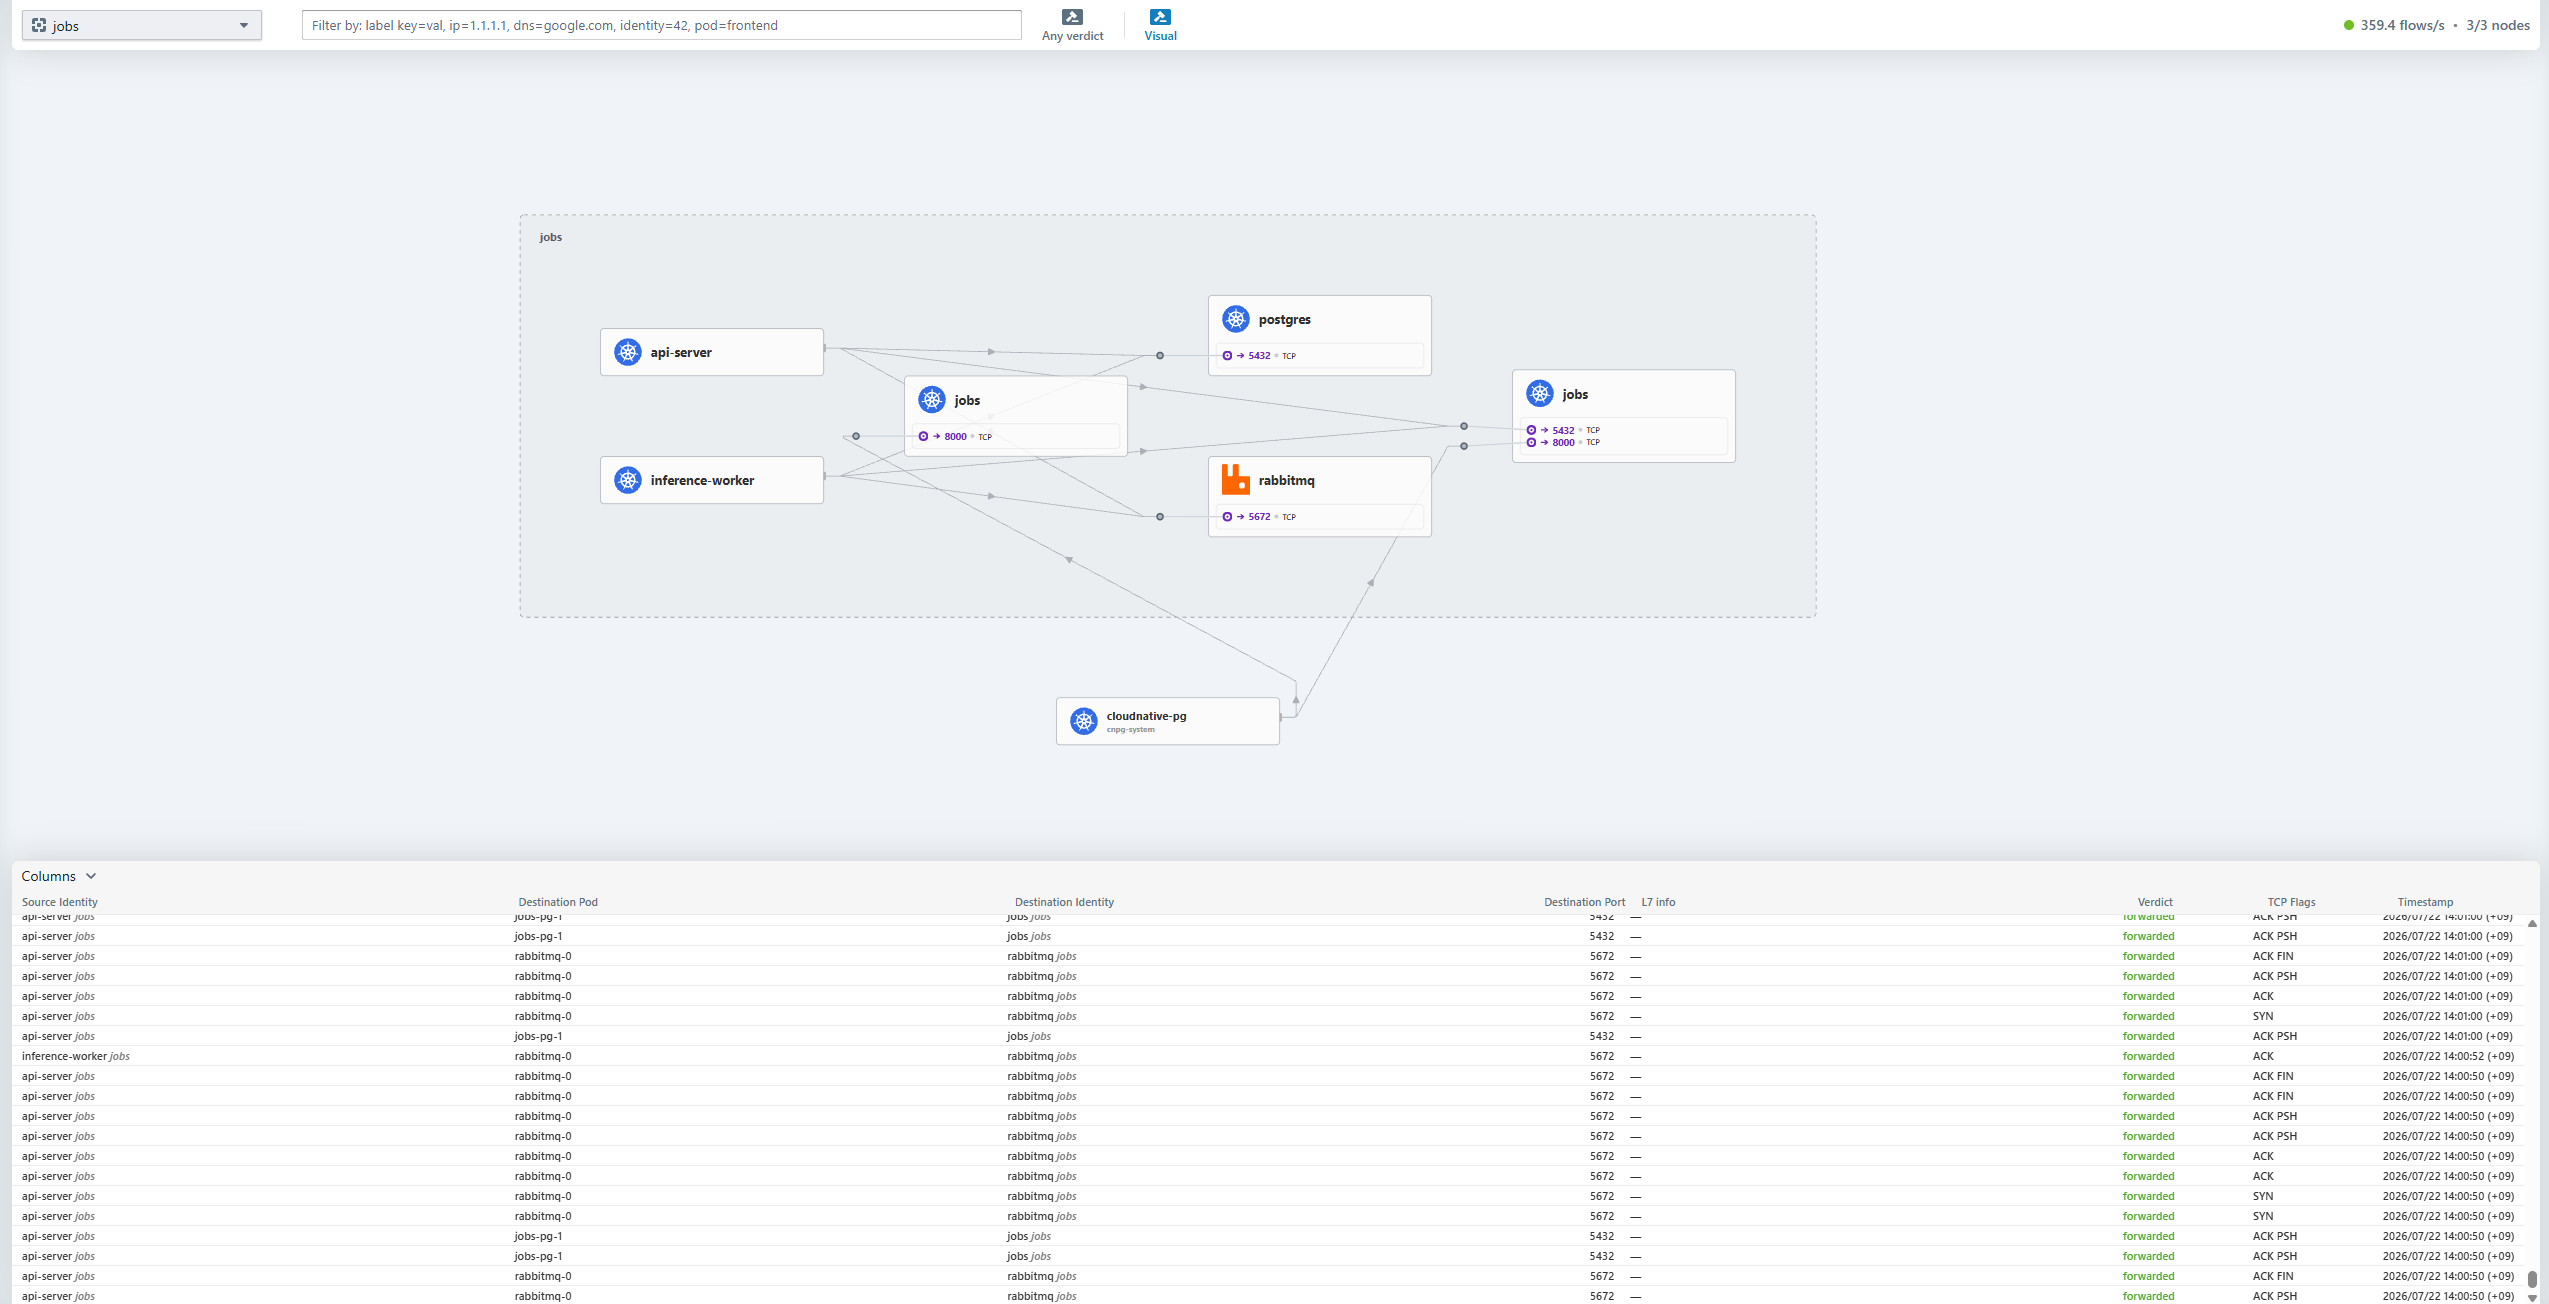
Cilium의 관측 도구인 Hubble은 실제 트래픽 흐름을 커널 레벨에서 그대로 보여준다. 이 랩에서 비동기 파이프라인(api-server → RabbitMQ → inference-worker → PostgreSQL)을 돌려보면서 hubble observe로 캡처해보니, api-server와 inference-worker 사이에는 직접 연결이 단 한 번도 없었다 - 큐를 통해서만 간접적으로 이어지는 아키텍처가 설계 문서가 아니라 실제 패킷 기록으로 증명된 셈이다.
번외: AWS로 이 랩을 돌리면서 비용은 어떻게 관리했나
학습용 클러스터라 상시로 켜둘 이유가 없어서, 인스턴스 자체를 **스팟(persistent, 중단 시 stop)**으로 띄웠다 - 온디맨드보다 저렴하고, 스팟 회수(interruption)가 발생해도 종료가 아니라 정지 상태로 남아서 데이터가 보존된다. 여기에 세션이 끝나는 저녁마다 aws ec2 stop-instances로 3대를 수동 정지해서 컴퓨팅 과금 자체를 껐다 - EBS(디스크)는 정지 중에도 과금되지만 컴퓨팅에 비하면 미미하고, etcd·Longhorn·DB 데이터는 그대로 보존된다.
Elastic IP(고정 공인 IP)도 일부러 안 붙였다 - 붙이면 인스턴스를 재시작해도 주소가 안 바뀌어서 편하지만, 학습용 랩 규모에서 굳이 그 비용을 낼 이유가 없다고 판단했다. 대신 재시작할 때마다 바뀌는 새 공인 IP를 스크립트로 조회해서 로컬 hosts 파일을 자동 갱신하는 쪽을 택했다 - 클러스터 내부 통신은 Private IP(고정) 기준이라 재시작 자체에는 영향이 없고, 바뀌는 건 브라우저로 접속할 때 쓰는 공인 IP뿐이었다.
"당연히 필요할 것 같은 옵션(EIP)"을 규모에 안 맞으면 빼는 것도, MetalLB처럼 "온프레미스에서 당연한 것"을 클라우드에 그대로 옮기지 않는 것과 같은 결의 판단이다 - 실제 필요와 무관하게 익숙한 패턴을 그대로 가져오면 안 되는 경우가 있다.
왜 이 경험이 다른가
"Kubernetes 써봤다"는 이력서 문장은 대부분 "EKS/GKE에 kubectl apply를 해봤다"는 뜻이다 - 컨트롤플레인은 이미 떠 있고, 죽지 않고, etcd라는 단어를 몰라도 몇 년을 운영할 수 있다. 이 프로젝트에서 실제로 시간이 들어간 부분은 정확히 그 반대쪽이다.
- "etcd 쿼럼이 깨지면 무슨 일이 일어나는가"를 실제로 만들어봤다. 컨트롤플레인을 강제로 죽여서
kubectl이context deadline exceeded로 멈추는 걸 직접 보고, 남은 멤버 수로 과반수를 계산하는 절차를 손으로 따라가봤다 - 관리형 K8s에서는 이 화면 자체를 볼 기회가 없다. - CNI가 "네트워크 표준 인터페이스"라는 사실을 코드가 아니라 장애로 이해했다. 워커가 NotReady로 멈춰있는 이유, CIDR 불일치로 노드를 넘어가는 통신만 골라서 실패하는 증상처럼 관리형 환경에서는 마주칠 일이 없는 실패 모드를 직접 진단했다.
- 온프레미스에서 당연한 선택(MetalLB L2, kube-vip ARP)이 클라우드로 그대로 옮겨지지 않는다는 걸 실제로 부딪혀서 배웠다. AWS EC2 위에 같은 랩을 재현하면서 L2/ARP가 VPC에서 통하지 않는 이유, AWS Load Balancer Controller·ExternalDNS로 역할이 나뉘는 이유를 문서가 아니라 실패 로그로 확인했다.
- 네트워크 계층의 트레이드오프(BGP vs VXLAN, L2 vs BGP LB, iptables vs eBPF)를 "왜 이걸 골랐는가"까지 설명할 수 있다. 각 선택이 온프레미스 인프라의 제약(같은 서브넷인가, 라우터에 BGP 피어링 권한이 있는가)에서 나온 결정이라는 근거를 댈 수 있다.
누가 "이 프로젝트 얘기해보세요"라고 물으면, 이 중 어느 걸 물어도 "명령어를 실행해봤다"가 아니라 "왜 실패했고, 왜 이 방식을 골랐는지"로 답할 수 있다는 게 관리형 K8s 경험만 있는 엔지니어와의 실질적인 차이다.
체크리스트
- VM 2~3대에 kubeadm으로 클러스터 구축
- CNI 설치 (Calico)
- MetalLB, 스토리지(NFS 또는 Longhorn) 구성
- 클러스터 파괴 후 재구축 1회 (
kubeadm reset→ 위 절차 반복) -
etcdctl snapshot save로 백업 후snapshot restore로 복구 1회 실습 - (선택) 클라우드 K8s와 하이브리드 연동
- (선택 확장) kube-vip로 컨트롤플레인 3노드 HA + 강제 종료 실험
- (선택 확장) Calico → Cilium 마이그레이션 +
cilium connectivity test통과